Bullstory Research 7 de julio de 2026
Cuello de botella en el punto de inflexión del agente de IA
Puntos clave
La caché KV crea un cuello de botella de memoria, y 2026la comercialización de HBF en el año es el punto de inflexión que lo resuelve. HBF aumenta la capacidad de HBM en 8~16veces, lo que dispara la demanda de NAND. SK hynix lidera la estandarización.
La transición hacia la inferencia de IA ha convertido a NAND y a las SSD, de simples unidades de almacenamiento secundario, en recursos centrales de la infraestructura de IA. El almacenamiento que necesita un servidor de IA es 8~10 veces el de un servidor convencional, por lo que se dispara la demanda de SSD empresariales para acceso en tiempo real y de gran capacidad, como la caché KV. La demanda de NAND aumenta 20~22 % al año, pero como el cambio de capacidad es lento, continúa la presión sobre la oferta.
1. La aparición de AGENT AI
AGENT AI es una IA que, al recibir un objetivo, planifica por sí misma, elige herramientas, las ejecuta y evalúa los resultados.
Los LLM tradicionales eran solo chatbots. Estaban más cerca de una función de apoyo que de sustituir a las personas.
Sin embargo, AGENT AI entra directamente en el ordenador, trabaja como una persona y realiza tareas.
Y, a diferencia de los LLM, genera dinero. Para sobrevivir en la competencia y monetizar, las empresas de IA lo están apostando todo a los modelos de AGENT AI.
La burbuja de la IA apenas está en una fase inicial. No se puede reducir la inversión en CAPEX. Porque aparecen costes hundidos.
AGENT AI realiza muchísimo más trabajo que los LLM, por lo que surgen innumerables cuellos de botella.
Energía (SOFC, turbinas de gas) / CPU, GPU, TPU, NPU, HBM / memoria DRAM, NAND, HDD / sustratos, cobre * interconexiones como las comunicaciones ópticas
/semiconductores de potencia, PC con IA / construcción de centros de datos, neocloud / están surgiendo cuellos de botella innumerables veces.
2. ¿Por qué AGENT AI ahora?
La IA tradicional es un chatbot de una sola vez que responde cuando preguntas, y una persona debe dar instrucciones cada vez.
AGENT AI juzga y actúa por sí misma mediante objetivo → planificación → ejecución → retroalimentación → repetición.
AGENT AI es un 24-trabajador digital automatizado por horas que genera ingresos directos al eliminar tareas repetitivas, reducir costos laborales y aumentar las oportunidades de ventas.
Demanda empresarial en explosión "reducción real de costos, aumento de ventas"
-
Automatización de tareas repetitivas: demanda de empleados de IA en todos los ámbitos, incluidos soporte, ventas, finanzas y producto
-
24 empleados de IA a tiempo: el trabajo avanza incluso cuando no hay nadie presente → aumento de oportunidades de ventas
-
Reducción real de costos: entre las empresas que lo adoptan, 83% eliminó tareas repetitivas, 76% experimentó mejoras de productividad
Impacto en las ganancias: coste de implementación < costes laborales reducidos + aumento de ventas → el ROI (retorno de la inversión) es claro
3. Cuello de botella en la memoria (DRAM·NAND)
KV CACHE: La causa principal del cuello de botella de memoria
KV CACHE (caché de clave-valor) es una causa clave de los cuellos de botella de memoria en el proceso de inferencia de AGENT AI.
¿Qué es KV CACHE? Es una tecnología que almacena en memoria los valores de Key y Value calculados previamente cuando la IA genera oraciones, para usarlos de inmediato sin volver a calcularlos.
Problema: AGENT AI debe procesar millones de tokens en tiempo real, pero si la capacidad de KV CACHE supera el límite de memoria, la GPU tiene que simplemente esperar. Esto es el "Memory Wall".
Resultado: La velocidad de cómputo de la GPU ha aumentado de forma explosiva, pero si la memoria no puede suministrar datos a esa velocidad, las costosas GPU se desperdician.
Trasfondo del auge de la importancia de NAND
Con HBM basado en DRAM por sí solo, los límites de capacidad (192GB) y la carga de costes son elevados.
NAND (memoria flash NAND) se vuelve importante porque:
-
Capacidad: En comparación con DRAM, 10 veces más espacio de almacenamiento
-
Coste: En comparación con HBM, 8~16 veces más barata
-
No volátil: Los datos se mantienen incluso cuando se corta la energía
Punto clave: En la era de inferencia de IA, es esencial una memoria de gran capacidad y bajo coste para almacenar la KV CACHE → la demanda de NAND se dispara.
La estructura por la que la transición a la inferencia de IA está cambiando el mercado de NAND·SSD (2024~2026)
Con el o de OpenAI1 público (2024mes, 9) como punto de inflexión, el centro de la tecnología de IA se desplazó del entrenamiento a la inferencia. Este único cambio estructural alteró el mapa de la demanda de almacenamiento.
En la fase de inferencia, los modelos cargan rápidamente grandes volúmenes de datos para cada solicitud. A medida que el acceso al caché KV y a las bases de datos vectoriales se vuelve constante, la demanda de SSD empresariales de alta velocidad y gran capacidad se disparó junto con la demanda de GPU (TrendForce, 2026mes, 5).
Lo siguiente es el cambio visible. 2026El almacenamiento que requiere un servidor de IA en 8 a 10 veces el de un servidor convencional. La demanda de NAND aumenta entre 20 y 22 por ciento al año, mientras que la oferta solo alcanza entre 15 y 17 por ciento (Commercial Times, análisis de oscoo, 2026). La demanda avanza rápido, pero la producción y la reconversión de la capacidad no pueden seguir ese ritmo.
La paradoja de la reducción de la oferta de NAND
La razón por la que la oferta no puede seguir el ritmo pese al aumento de la demanda es la asignación de equipos de la industria. Samsung y SK hynix están convirtiendo las líneas de NAND hacia HBM. Esto se debe a que el margen de HBM supera el 60 por ciento. También hay informes de que la producción de obleas de Samsung cayó de 2025 unidades en 490 a 2026 unidades en 470. La inversión en instalaciones de NAND aumentó solo un 5 por ciento interanual. Micron dijo que su nueva fábrica no podrá entrar en funcionamiento hasta 2027. SK hynix afirmó en la presentación de resultados de 2025 que el volumen de ese año ya estaba completamente vendido (oscoo, storageswiss.com, 10).2026.2026.
Este cambio estructural intensifica la escasez de oferta a corto plazo. La demanda se está reorganizando en torno a los centros de datos y la inferencia, mientras que la oferta se orienta hacia la producción de HBM de alto margen. Como resultado, aumentan la presión sobre los precios y sobre el inventario de los SSD empresariales.
Precios de SSD y cambios en el mercado — Lo que está ocurriendo ahora
Los precios ya han reaccionado. El precio unitario de NAND TLC 1terabit pasó de 2025a mediados del año 4.80dólares a 2025a finales del año 10.70dólares, y se dijo que se había duplicado en 6meses (director ejecutivo de Phison, Tweaktown, 2025año 11mes).
Los precios de los SSD de consumo de 1TB también subieron. Los productos que estaban en **2025al comienzo del año 45~60dólares subieron a **2025después de 9mes del año 70~90dólares o más. Sandisk hizo público un caso en el que subió el precio del modelo WD Black SN2026TB al comienzo del año de 8100 4dólares → 549.99dólares (análisis de Kingspec, kitpa.org, 1,289.99año 2026mes).2.
Micron decidió en 2025mes del año 12cerrar su negocio de marca de consumo, Crucial. Dejó de enviar nuevos productos de consumo desde 2026mes del año 2y redirigió toda la producción a usos de IA y empresariales (oscoo, 2026año).
Un cambio histórico: los SSD empresariales superan a los móviles
2026Es muy probable que ese año sea el primero en el que los centros de datos superen al móvil y se conviertan en el mayor destino de la demanda de NAND. El director ejecutivo de Sandisk dijo en la presentación de resultados de 2026 de 1 que el crecimiento de capacidad de NAND para centros de datos se situaría en el "rango alto de un dígito anual". Los ingresos de NAND de Micron en el ejercicio fiscal 60 se estiman en Wall Street en un aumento del 2026% interanual hasta unos 178mil millones de dólares (presentación de resultados de Sandisk, Zacks, 236).2026}
TrendForce elevó su previsión del tamaño del mercado mundial de NAND flash para 2026 a 2,706mil millones de dólares. Esa cifra equivale a un 281% de crecimiento interanual. TrendForce también presentó una previsión de expansión adicional hasta 2027mil millones de dólares en 3,794. No obstante, también existe la visión del sector de que será difícil una expansión real de la oferta hasta alrededor de 2027finales de año y 2028 o antes (TrendForce, 2026 de 5).
Conclusión: A medida que la inferencia de IA se convierte en el centro de la demanda de almacenamiento, NAND y SSD han pasado de ser simples dispositivos de almacenamiento secundario a un recurso clave de la infraestructura de IA. En comparación con el fuerte aumento de la demanda, la conversión de las instalaciones es lenta. Por ello, los SSD empresariales y el NAND de gran capacidad se han convertido en puntos de inversión a corto plazo y estructurales en el sector de memoria y almacenamiento.
Tecnología HBF: superar entre 8 y 16 veces el límite de capacidad de HBM
HBF (High Bandwidth Flash) no sustituye a HBM, sino que es una memoria de nueva generación que complementa las limitaciones de capacidad de HBM.
Explicación clave de HBF
-
Material: NAND flash (diferente de HBM basado en DRAM)
-
Capacidad: en comparación con HBM, 8~16 veces mayor (hasta 4TB por GPU posible)
-
Velocidad: alrededor de 80~90% de HBM (lo suficientemente rápido)
-
Costo: con un costo similar, 8~16 veces la capacidad
-
Función: HBM es caché (procesamiento rápido de datos), HBF es una biblioteca (almacenamiento de modelos de IA a gran escala)
Estructura técnica de HBF
-
3NAND apilado tridimensional: varios dies NAND apilados verticalmente en un solo paquete
-
TSV (vía a través del silicio): conecta verticalmente cada die NAND, ampliando el ancho de banda
-
CBA (unión de oblea): une directamente las celdas de memoria y los circuitos, mejorando el rendimiento
-
múltiples subarreglos: maximiza el ancho de banda de lectura mediante acceso simultáneo
Comercialización
-
2026 segunda mitad: se proporcionan las primeras muestras de memoria HBF
-
2027 a comienzos del año: primera muestra de un dispositivo de inferencia de IA equipado con HBF
Empresas relacionadas
-
SK Hynix: firmó un MOU con SanDisk y lidera la estandarización de HBF
-
Samsung Electronics: produce tanto DRAM como NAND y tiene una oportunidad en HBF
-
SanDisk (Western Digital): lidera el desarrollo de la tecnología HBF
Punto clave: 2026 la comercialización de HBF en el año es una variable clave en el fuerte aumento de la rentabilidad del mercado de memorias.
Explosión de la demanda de HDD: esencial para el almacenamiento de gran capacidad
HDD (disco duro) es 5~8 veces más barato que SSD y óptimo para el almacenamiento de gran capacidad.
Contexto del aumento de la demanda de HDD
-
El volumen de datos de IA 3 veces se disparó(2023~2028, 400zettabytes)
-
Aproximadamente 80% se almacena en HDD por su eficiencia de costes
-
Archivo de datos de entrenamiento e inferencia: se necesita almacenamiento → HDD ofrece una buena relación calidad-precio
Tendencias recientes del mercado de HDD
-
Precio del HDD: el precio de suministro 4% subió, el precio de venta real 20% subió
-
Plazo de entrega del HDD: se amplió hasta 1años o más (fenómeno de escasez)
-
2026año: los envíos rebotaron
-
2028año: los envíos 2 millones de unidades superaron, la capacidad máxima individual de 60TB alcanzó
Empresas relacionadas
-
Western Digital: HDD mundo 1y superior, aumento inmediato de precios en todos los productos
-
Seagate: HDD 2y superior, anuncio de un plan para subir precios
Conclusión
KV CACHE es la causa principal de los cuellos de botella de memoria, y **HBF es la memoria de IA de nueva generación que 8~16supera por un factor de
NAND está cobrando cada vez más importancia por su gran capacidad y bajo coste, y HDD es esencial para el almacenamiento de gran capacidad. (Si sube el precio de SSD, HDD también se beneficia)
2026comercialización de HBF en el año es una variable clave para un fuerte aumento de la rentabilidad en el mercado de memoria. Liderado por SK Hynix, Samsung Electronics y SanDisk.
4. Cuello de botella en la red
AGENT AI no trabaja sola. Miles de GPU colaboran en equipo para entrenar o inferir un único modelo grande.
Problema: La velocidad de procesamiento de las GPU ha aumentado de forma explosiva, pero la velocidad de la red que conecta las GPU no logra seguirle el ritmo.
Resultado: Las GPU pasan más tiempo esperando datos, lo que hace que GPU costosas se desperdicien. Esto es un "cuello de botella de red".
Si la velocidad de conexión de las GPU no alcanza a la velocidad de procesamiento de las GPU, toda la infraestructura de IA se bloquea.
Empresas relacionadas
-
CRDO: chip de interconexión ultrarrápida entre aceleradores de IA Clave: chip de interfaz para la transferencia de datos entre GPU, antes de PAM4 transceptor de alta velocidad
-
ALAB: chip CPO que integra las comunicaciones ópticas en el chip, solución de interconexión óptica GPU a GPU Clave: ventaja de pionero en la tecnología CPO, liderazgo en la integración de chip + módulos ópticos
-
ANET: para centros de datos de IA 400G/800G switches, switches Ethernet de gran ancho de banda Clave: principal cliente de CLS, liderazgo en redes para centros de datos de IA
-
CLS: switches de gran ancho de banda, switches white-box, fabricante clave de racks y switches de red para servidores de IA (fabricación de switches basada en CPO)
Antecedentes del interés en las comunicaciones ópticas
La comunicación óptica es una tecnología que transmite datos utilizando luz y es mucho más rápida que los cables y consume menos energía.
Por qué la comunicación óptica está llamando la atención:
-
Alta velocidad: capaz de transmitir varios terabits por segundo (Tbps)
-
Bajo consumo: 50ahorro de energía frente a los cables
-
Baja latencia: minimiza el retardo de la señal
-
Gran capacidad: esencial para la transmisión masiva de datos en los centros de datos de IA
Punto clave: Para conectar miles de GPU en los centros de datos de IA, la comunicación óptica es esencial.
Crecimiento de MRVL
3Tras un contrato con Nvidia, creció de forma muy pronunciada, y al entrar en el ecosistema de Nvidia, Jensen Huang recientemente 1hizo comentarios sobre la empresa
-
Crecimiento explosivo del tráfico de datos entre servidores de IA → 800G·1.6T switches Ethernet se dispara la demanda
-
Los racks de IA requieren comunicación óptica → Marvell es un proveedor clave de transceptores ópticos
-
Junto con Broadcom, 2líder de switches Ethernet
-
Marvell es un actor clave en las redes de centros de datos de IA, una empresa que representa el cuello de botella de redes y comunicaciones ópticas en la estructura de cuello de botella de las placas
Tecnología CPO: la clave para resolver los cuellos de botella de redes
CPO (Co-Packaged Optics) es una tecnología que integra los componentes de comunicación óptica con un chip en un mismo paquete, reduciendo al mismo tiempo la latencia de transmisión de datos y el consumo de energía.
Método tradicional:
-
El módulo de comunicación óptica está separado del chip
-
Los datos viajan hasta el módulo por cables → se producen pérdidas de energía y latencia
Método CPO:
-
El módulo de comunicación óptica está en un solo paquete con el chip (integrado físicamente)
-
Los datos están conectados directamente → energía 50% de ahorro, minimizando la latencia
Estado de avance de la tecnología CPO
| Elemento | Detalle |
|---|---|
| Ancho de banda | Existente 400G → 1.6T o más |
| Energía | 50% de ahorro |
| Comercialización | 2026 años para adopción a gran escala |
| Mercado | 2028 años 100 mil millones de dólares o más |
Empresas relacionadas
-
LITE : transceptores ópticos, láseres, detectores y otros componentes clave de comunicaciones ópticasclave: suministro de módulos de comunicaciones ópticas, producción de dispositivos ópticos para CPO
-
COHR : transceptores ópticos de alto rendimiento: 800G/1.6T módulos de comunicaciones ópticas, láseres para comunicaciones ópticasclave (dispositivos ópticos de gran ancho de banda, suministro de módulos ópticos CPO)
-
AAOI : 400G/800Transceptor óptico G: para centros de datos de IA, soluciones Ethernet de alta velocidadClave: suministro de módulos de comunicaciones ópticas, redes de servidores de IA
-
MXL : PPM: chips de procesamiento de señales de comunicaciones ópticas, componentes analógicos para redesClave: procesamiento de señales de comunicaciones ópticas, chips de red
-
TSEM : empaquetado de semiconductores e integración de chips, tecnología de unión de obleas, 3empaquetado de circuitos integrados tridimensionales: tecnología para apilar chips verticalmente
-
VIAV : pruebas y medición de redes de comunicaciones ópticas, equipos de prueba CPO
-
POET : interpuesto óptico, Optical I/O: enlaces de comunicaciones ópticas entre aceleradores de IAClave (aseguramiento del liderazgo en tecnología CPO, integración de chip + módulo óptico)
-
KEYS : equipo de medición de comunicaciones: verificación del rendimiento de transceptores ópticos, pruebas de interfaces de alta velocidad: 112G PAM4 comprobación
-
GLW : Fibra óptica: interconexión ultrarrápida entre centros de datos, Sustrato de vidrio: integración de chips basada en CPO
Materiales para dispositivos fotónicos: componentes de comunicaciones ópticas como láseres y detectores clave (materiales de comunicaciones ópticas, suministro de sustratos de vidrio para CPO)
5. Cuello de botella de la CPU
El cuello de botella de la CPU en la era de AGENT AI puede resumirse así: “No basta con que la GPU sea rápida”. En las cargas de trabajo agénticas, las tareas de tipo CPU, como la orquestación, la gestión de memoria, el preprocesamiento de datos, la ejecución de herramientas y la programación, aumentan aún más que la propia inferencia, por lo que la importancia de la CPU ha vuelto a crecer.
La IA generativa inicial parecía reducirse a “la GPU lo es todo”, pero con AGENT AI la cantidad de trabajo que asume la CPU se disparó. Los agentes de IA no solo llaman al modelo; también tienen que coordinar varios pasos, llamar a herramientas externas, mover datos y volver a enlazar los resultados, de modo que la CPU pasó a desempeñar mucho más a menudo el papel de ordenar el tráfico del sistema.
El punto clave es que, si la CPU es lenta, la GPU termina quedándose ociosa. NVIDIA también presentó la CPU Vera y explicó que la IA agéntica, el aprendizaje por refuerzo, el procesamiento de datos y la orquestación son tareas intensivas en CPU, y que Vera es x86 más rápida que la CPU al completar tareas de agente80%
Por qué es un punto de inflexión ahora
El mercado ya considera que la estructura de la demanda de CPU está cambiando. Algunos análisis del sector señalaron que, en el despliegue tradicional de LLM, la proporción de CPU era de aproximadamente 15%, pero, a medida que se expande AGENT AI, esa proporción podría aumentar hasta 50%.
Este cambio no es solo una carrera de rendimiento; también trae consigo un cambio de arquitectura. Arm dijo que su cuota basada en los ingresos de CPU para centros de datos podría subir hasta 2025en 50%, y también surgió una previsión de que, en el mercado de CPU host para servidores ASIC de IA, las CPU basadas en Arm podrían representar 2029al comienzo de 90%.
Empresas relacionadas
-
AMD: En el periodo en que la demanda de CPU vuelve a crecer gracias a AGENT AI, AMD está aumentando su cuota de CPU para servidores, y la familia EPYC sigue arrebatando cuota a Intel
-
ARM: Es probable que se beneficien los hyperscalers que usan el propio Arm y CPUs de servidor basadas en Arm. Las CPUs de Arm tienen una gran eficiencia energética, y en los servidores de IA el papel de la CPU host o del controlador de tráfico está ganando peso, por lo que se espera una expansión estructural de la cuota de mercado.
-
NVDA (Vera Rubin)
-
INTC
6. La llegada de Vera Rubin
Vera Rubin (Vera Rubin) es la plataforma de IA de nueva generación de NVIDIA, y no es simplemente un chip más rápido, sino un sistema que rediseñó desde cero toda la fábrica de IA.
-
3.3 mejora de rendimiento: en comparación con Blackwell, 3.3 veces de rendimiento, 3.5 veces de entrenamiento, 5 veces de inferencia de mejora
-
HBM4 incorporada: 6-generación de memoria de alto ancho de banda (suministro exclusivo de SK hynix y Samsung Electronics), 8 pilas de HBM4 para un ancho de banda ultraalto
-
Integración de la CPU Vera: una CPU completamente dedicada a la IA que sucede a la CPU Grace existente, encargada de las llamadas a herramientas, la ejecución de código y el procesamiento de datos de los agentes de IA
-
Arquitectura a escala de rack: NVL72(72 CPU + 144 GPU) → un superordenador
-
Eficiencia energética: en comparación con Blackwell, coste de computación por token significativamente menor
Competencia en el mercado de CPU que traerá Vera Rubin
Vera Rubin señala la entrada directa de NVIDIA en el segmento de CPU, y86crea un cambio estructural al sumar a NVIDIA a la competencia de x (AMD e Intel) frente a Arm.
Panorama competitivo
-
NVIDIA vs AMD vs Intel: Vera CPU está diseñado exclusivamente para agentes de IA, aprendizaje por refuerzo y procesamiento de datos; frente al x existente86 ofrece 50% más de velocidad y 2x de eficiencia
-
Expansión de la cuota de AMD: 2026 año 1 trimestre x86 la cuota de CPU para servidores subió a <strong>33.2%</strong>, mientras Intel 55% → bajó
-
Fuerte crecimiento de Arm: las CPU para servidores de Arm alcanzaron 2025 año 50%, y se espera 2029 año 90%
Vera Rubin es una señal del paso de una infraestructura de IA centrada en GPU a un co-diseño CPU+GPU.
La entrada directa de NVIDIA en el ámbito de la CPU mientras86x vs Arm vs NVIDIA3comienza la batalla de los semiconductores
Empresas relacionadas
-
SK Hynix, Samsung Electronics, Micron : suministro de4HBM
-
CLS : fabricación ODM, fabricación de racks de servidores de IA e interruptores de red, 1arriba
-
FLEX : gestión de energía, refrigeración, 110suministro de power shelf de kW y CDU de refrigeración líquida
-
Hanmi Semiconductor : equipos de empaquetado HBM
-
HPSP: fabricación de servidores, suministro de servidores compatibles con Vera Rubin NVL72.
-
EO Technics: HBM4. equipos de prueba
-
CRWV, NBIS: las empresas neocloud CoreWeave y Nebius tienen previsto incorporar Vera Rubin (GTC 2026)
7. La IA está saliendo de la nube
AGENT AI no es una IA de simples respuestas, sino que debe tomar decisiones y actuar en tiempo real. Por eso, las limitaciones de depender solo de la nube se han vuelto evidentes. Las razones clave son la latencia, la seguridad y el coste.
Enviar datos a la nube cada vez hace que la respuesta sea más lenta, la información sensible salga al exterior y las tarifas de uso aumenten a medida que crecen las solicitudes. Por eso, la IA se está trasladando cada vez más a donde están los datos, donde están los dispositivos y donde está el lugar de trabajo.
IA local
La IA local es un modelo en el que una empresa ejecuta la IA directamente en sus propios servidores o dentro de su centro de datos interno. Es especialmente importante en ámbitos como las finanzas, la salud y el sector público, donde una fuga de datos sería crítica.
La clave es la seguridad y la soberanía de los datos. Como los datos no se envían a una nube externa, el cumplimiento normativo es más fácil y los datos sensibles, como documentos internos, información de clientes y datos de equipos, pueden gestionarse con mayor seguridad.
Empresas relacionadas
-
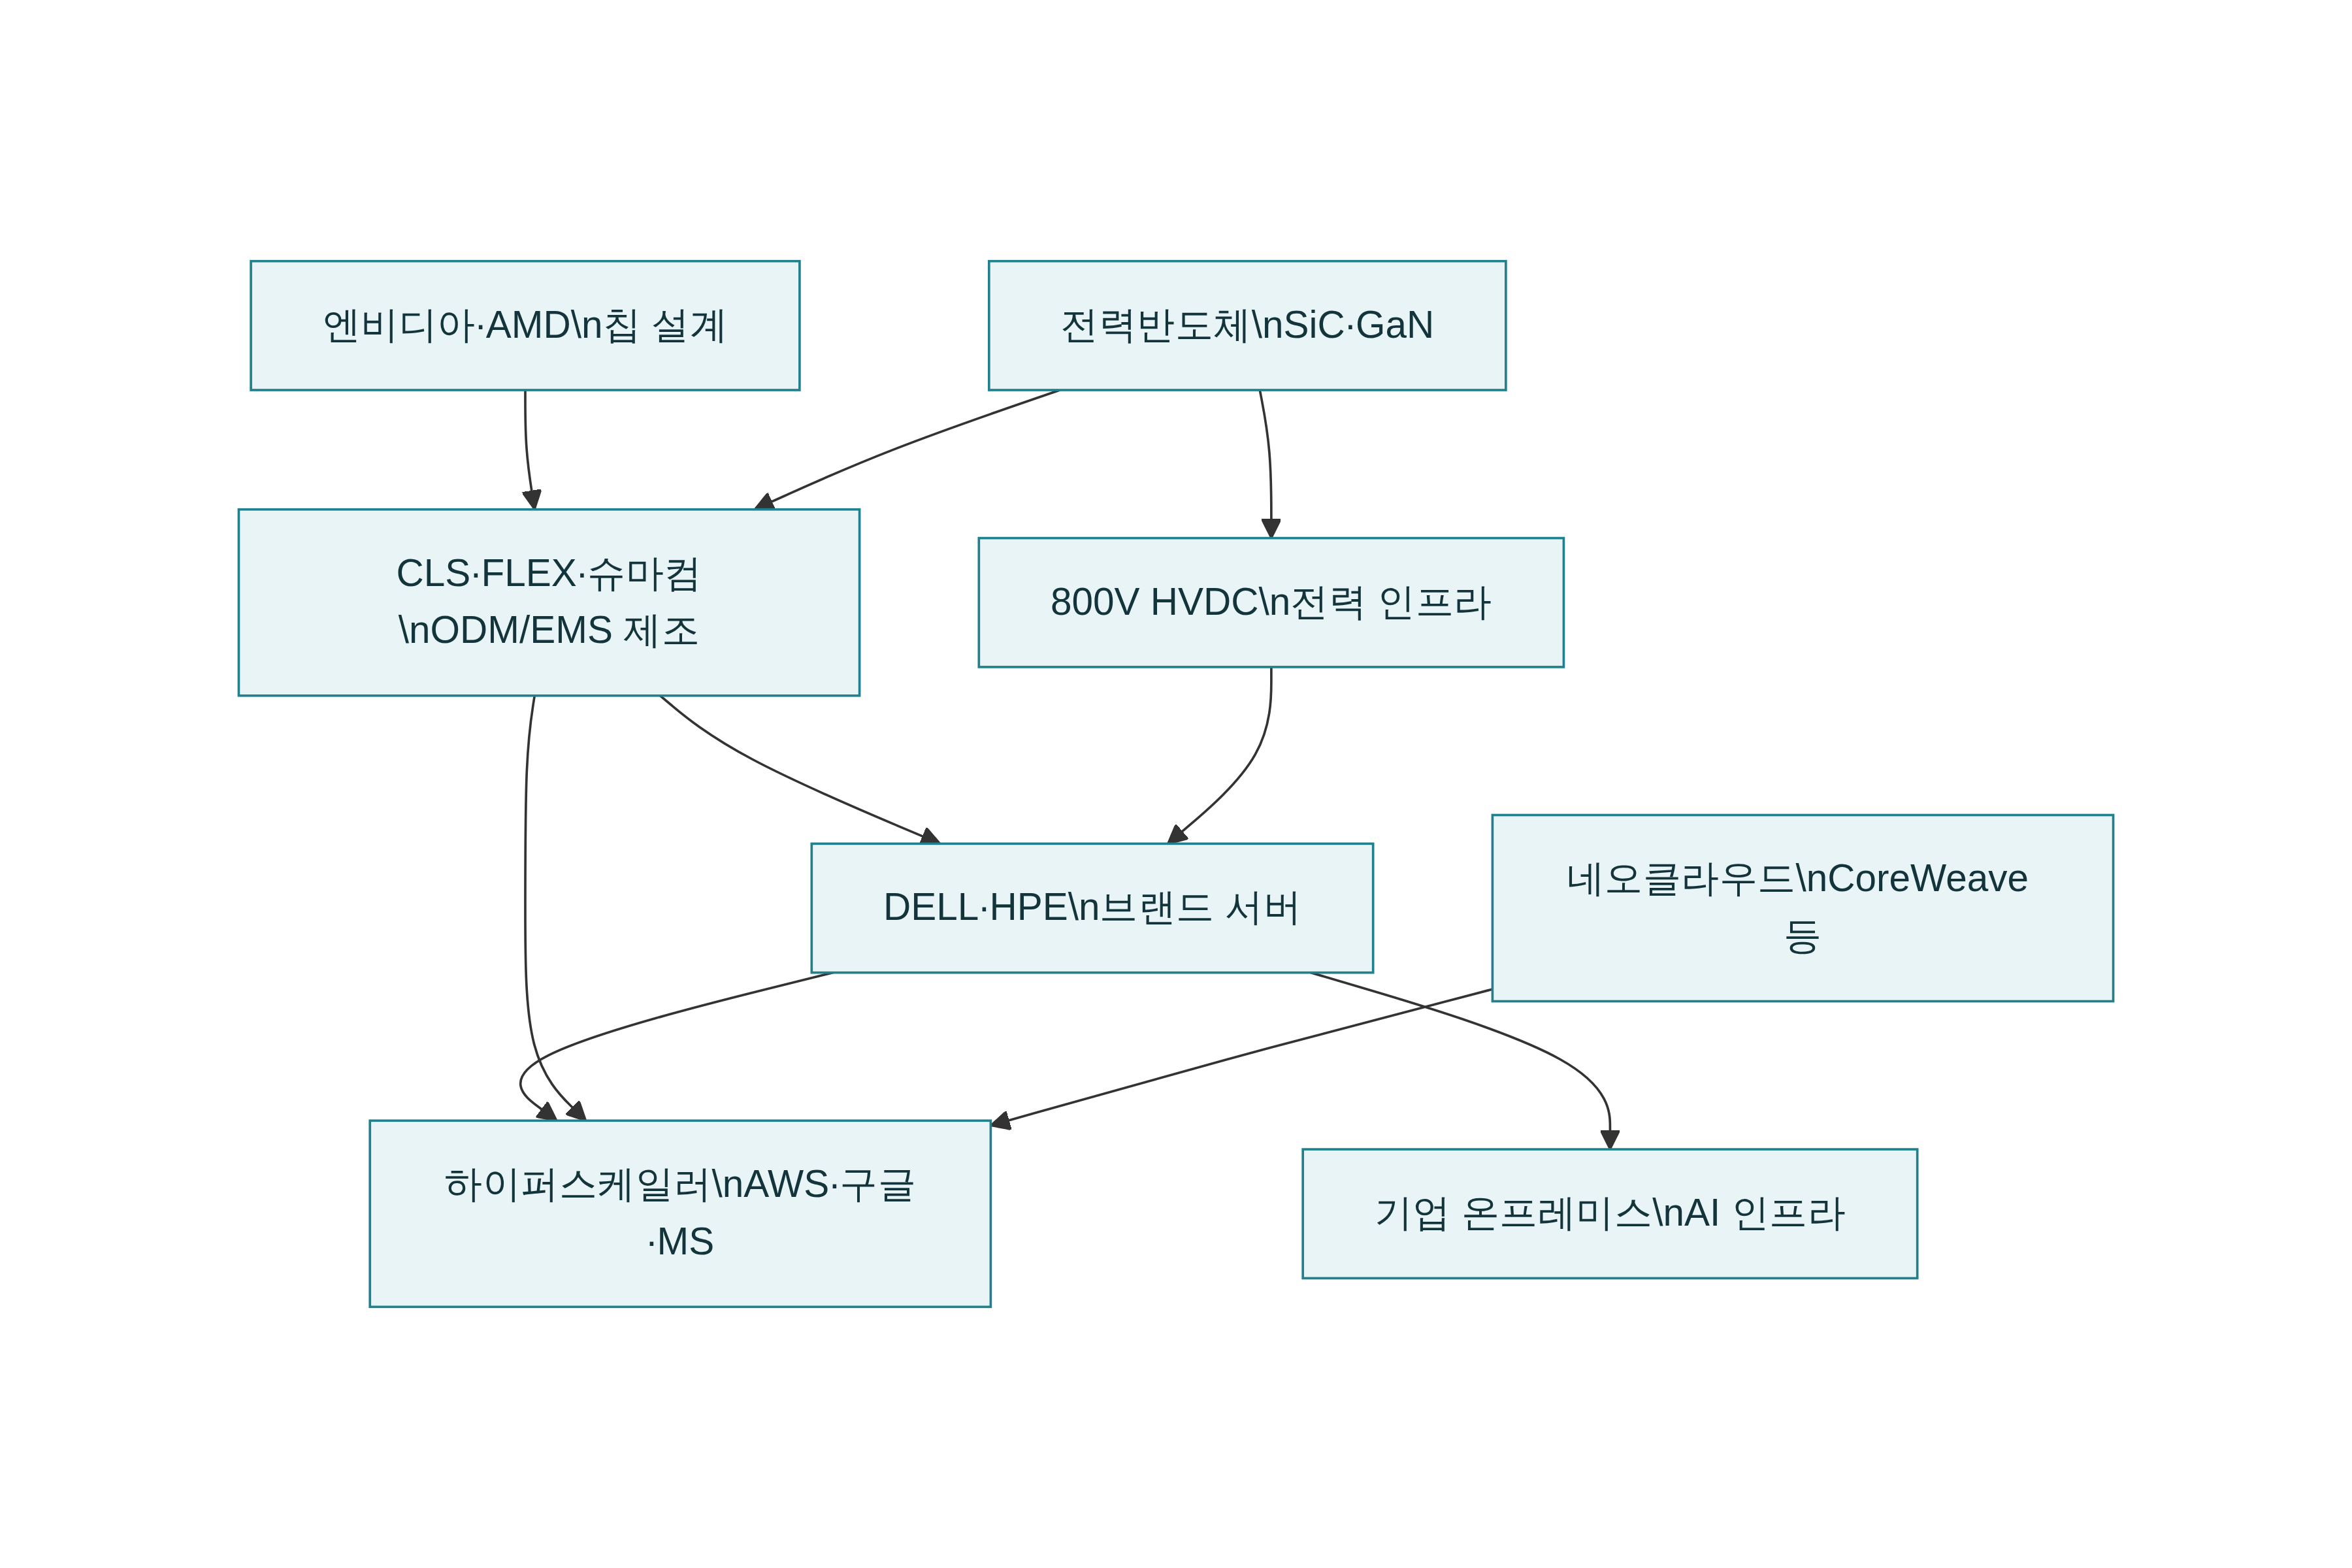
Dell, HPE: Empresas de infraestructura representativas que construyen servidores de IA dentro de las empresas.
-
CLS, FLEX: socios fabricantes detrás de DELL·HPE que producen servidores, energía y equipos de red reales.
-
BiMatrix, Konan Technology, Synapsoft: empresas en las que se espera un beneficio por la demanda doméstica de software de IA local y LLM.
IA en el dispositivo
La IA en el dispositivo es una forma de ejecutar la IA directamente dentro de dispositivos como teléfonos inteligentes, PCs, portátiles y automóviles. Como no pasa por la nube, es rápida, funciona sin conexión y resulta favorable para la protección de la privacidad.
La razón por la que este enfoque se ha vuelto importante es que AGENT AI debe responder de inmediato justo al lado del usuario. A medida que dispositivos personales como AI PCs, teléfonos inteligentes con IA y wearables se convierten en el primer espacio de ejecución de la IA, la IA en el dispositivo está creciendo rápidamente [http://있다.semiconductor.samsung).
Acciones beneficiarias clave
-
Apple, Samsung Electronics, LG Electronics: Empresas representativas que impulsan directamente la IA en el dispositivo en smartphones, PC y electrodomésticos.http://기업들이다.blog)
-
Qualcomm: Una empresa clave en chips de computación de IA de bajo consumo y en el ecosistema NPU
-
SK hynix, Samsung Electronics: Beneficiarias directas del aumento de la demanda de memoria de bajo consumo para móviles y AI PC.http://수혜주다.blog)
-
Openedges Technology, Chips&Media, Jeju Semiconductor: A menudo se agrupan como beneficiarias relacionadas con IP para IA en el dispositivo, procesamiento de video y memoria de bajo consumo.
IA en el borde
La IA en el borde es un método para ejecutar IA directamente en el lugar donde se generan los datos, como fábricas, cámaras, robots, vehículos y dispositivos médicos. La clave es que toma una decisión inmediata en el sitio antes de enviar los datos a la nube.
La razón por la que la IA en el borde es importante es la inmediatez. La conducción autónoma, la automatización industrial, las cámaras inteligentes y los robots necesitan tiempos de respuesta en milisegundos, no en segundos, por lo que no pueden esperar un viaje de ida y vuelta a la nube.
Acciones beneficiarias clave
-
NVIDIA: el centro del ecosistema de GPU y plataformas para la IA en el borde una empresa.
-
Qualcomm, MediaTek: acciones beneficiarias clave de la demanda de chips de IA en el borde de bajo consumo
-
Samsung Electronics, SK hynix, Micron: acciones beneficiarias representativas a medida que la demanda de memoria aumenta con la expansión de la IA en el borde.
-
LSCC, CEVA, SYNA: pueden considerarse acciones beneficiarias de la IA en el borde en términos de FPGA de bajo consumo, IP de diseño e interfaces de conectividad.
8. La importancia de los semiconductores de potencia
Por qué ha cobrado importancia
Los servidores de IA ahora se centran más en cómo suministrar electricidad de forma estable, perder menos energía y reducir la generación de calor que en el cómputo. NVIDIA también considera que la estructura eléctrica existente de racks de 54V no puede hacer frente a los futuros racks de IA de clase MW, y está impulsando una transición a una 2027a partir de 800infraestructura eléctrica de centros de datos basada en HVDC de V.
La clave es la densidad de potencia. A medida que aumentan las GPU en los centros de datos de IA, las pérdidas de energía, la generación de calor y la carga de refrigeración crecen al mismo tiempo, y en ese punto los semiconductores de potencia que convierten y controlan la electricidad se convierten en el cuello de botella. Por eso los semiconductores de potencia GaN y SiC, fuertes en alto voltaje, alta frecuencia y alta eficiencia frente a los componentes basados en Si, han pasado a ser componentes clave.
Por qué SiC y GaN
SiC es fuerte en entornos de alto voltaje, alta temperatura y alto calor, por lo que resulta ventajoso para la conversión de alta potencia.
En la práctica, se evalúa que SiC reduce las pérdidas de potencia y favorece la gestión térmica y la miniaturización del sistema debido a sus características de alto voltaje de ruptura, alta conductividad térmica, alta frecuencia de operación y alta temperatura de operación.
GaN es fuerte en frecuencias de conmutación más altas y alta densidad de potencia. Para las 800arquitecturas de centros de datos de IA, se explica que GaN admite frecuencias más altas que SiC, por lo que resulta adecuado para estructuras de suministro de energía de alta densidad.
800El cambio creado por V HVDC
800El significado de la transición a V HVDC no es simplemente un aumento de voltaje. Es un cambio estructural que busca al mismo tiempo mejorar la eficiencia energética, reducir los costos de mantenimiento y ampliar la densidad de potencia.
La arquitectura V HVDC presentada por Nvidia y Navitas mostró efectos de 800el sistema 54V existente frente a una mejora de la eficiencia energética de hasta 5puntos porcentuales, costos de mantenimiento 70reducidos en %.
Este cambio estructural ha elevado los semiconductores de potencia de “componentes auxiliares” a “componentes clave de la infraestructura de IA”.
Algunos análisis también señalaron que se prevé que el mercado de semiconductores de potencia de GaN crezca a una tasa media anual de 2023 años 2cien millones7,100diez mil dólares desde 2030 años 43cien millones7,600diez mil dólares, y 49%
Cadena de valor
En términos simples, la cadena de valor de los semiconductores de potencia tiene la estructura de suministro de energía → conversión de voltaje → distribución en rack → conversión interna de energía del servidor. Aquí, los semiconductores de potencia se utilizan en UPS, PSU, convertidores DC-DC y módulos de potencia, y su importancia aumenta a medida que los servidores de IA requieren más potencia.
-
Materiales/chips de dispositivo: semiconductores de potencia GaN, SiC
-
Módulo/conversión de potencia: PSU, rectificador, convertidor DC-DC power+1
-
Equipos de energía: dispositivos de suministro de energía HVDC, sistemas de distribución, infraestructura eléctrica para racks
-
Destinos finales de la demanda: centros de datos de IA, servidores de IA, racks de clase MW
La razón por la que los semiconductores de potencia se han vuelto importantes en la era de la IA es simple. Es más importante convertir esa electricidad de forma eficiente y soportarla que añadir más GPU.
NVIDIA anunció que cambiaría a una arquitectura de alimentación para centros de datos de IA basada en HVDC de 2027año desde 800V, y los semiconductores de potencia GaN y SiC, fuertes en alta tensión y alta eficiencia, han surgido como componentes clave.
La beneficiaria más directa es Navitas. En la cadena de valor global, Infineon, ST, TI y ROHM, y en Corea, empresas de infraestructura eléctrica como LS Electric, HD Hyundai Electric, Hyosung Heavy Industries y Sanil Electric pueden considerarse ejes clave de beneficio.
Empresas relacionadas
-
TXN: Socio oficial de NVIDIA
-
ON: socio oficial de NVIDIA, el único integrado verticalmente en SiC
-
NVTS: el único puro de GaN
-
STM: el mayor de Europa en SiC + GaN
-
MPWR: DC-DC/IC
-
COHU: equipo de prueba
-
AMKR / ASE: empaquetado
-
DB HiTek : el mayor 8fundición de pulgadas
-
KEC : SiC 1200V de fabricación local
-
RFHIC : única producción en masa de GaN en Corea
-
RF Materials : paquetes RF de GaN, fabricación local de obleas epi
-
QRT : especializada en evaluación de fiabilidad de semiconductores de potencia, pruebas HBM
-
ALT : solución total de posprocesado para semiconductores no memoria
9. Cuello de botella de los servidores — empresas de servidores de marca frente a ODM/EMS
Con la llegada de la era de AGENT AI, el cuello de botella se ha trasladado al sistema completo del servidor.
Cuando la IA sale de la nube, no basta con usar solo un centro de datos; hay que construir servidores por separado en distintos lugares.
A medida que los puntos de despliegue se dispersan desde una sola nube hacia miles, decenas de miles y cientos de miles de lugares, la demanda total de servidores ha crecido de forma exponencial.
Ahora, más que asegurar una sola GPU, es más difícil suministrar a tiempo un servidor en el que memoria, energía, refrigeración, placas y red funcionen todos en conjunto para que esa GPU opere correctamente [http://어려워졌다.biz)
En particular, los servidores de IA tienen una densidad de potencia mucho mayor que los servidores generales tradicionales, y su arquitectura de suministro de energía también es más compleja. A medida que el consumo de energía de las GPU de nueva generación se ha disparado, ha aumentado estructuralmente la cantidad de componentes de conversión y control de potencia necesarios y, como resultado, el propio ensamblaje y la entrega de servidores han empezado a convertirse en cuellos de botella. En el mercado, se considera que los cuellos de botella en componentes como las placas de circuito impreso, los semiconductores de potencia y la refrigeración pueden incluso reducir la tasa de crecimiento de los servidores.
Qué hacen las empresas de servidores de marca
Las empresas de servidores de marca son, en pocas palabras, empresas que diseñan, integran y venden servidores a los clientes. Entre los ejemplos representativos se encuentran empresas como DELL y HPE.
Integran GPUs, CPUs, memoria, almacenamiento, equipos de alimentación, equipos de refrigeración y redes en un único sistema y lo suministran al cliente final. En otras palabras, la cara del “servidor terminado” que ve el cliente es la empresa de servidores de marca.
Qué son ODM / EMS
ODM son las siglas de Original Design Manufacturer, y es un modelo en el que el fabricante se encarga tanto del diseño como de la producción. La empresa desarrolla y fabrica productos según los requisitos del cliente, y luego la empresa de marca vende esos productos.
EMS es la sigla de Electronics Manufacturing Services y se refiere a un modelo de servicios de fabricación electrónica que incluye fabricación, aprovisionamiento, parte del diseño, pruebas y logística. Dicho de forma sencilla, no es solo una planta de ensamblaje simple, sino un socio de fabricación que opera la cadena de suministro y la producción en nombre de la empresa de marca.
La diferencia clave es esta. Las empresas de servidores de marca captan el mercado y a los clientes, mientras que ODM/EMS respalda el producto real mediante diseño, producción, aprovisionamiento y logística.
En el mercado de servidores de IA, ambos son menos competidores que una estructura de simbiosis. Cuando una empresa de servidores de marca asegura clientes y define las especificaciones del servidor, ODM/EMS lo convierte rápidamente en un producto real.
Por ejemplo, empresas de marca como DELL y HPE venden servidores de IA a clientes corporativos e hiperescaladores, pero el chasis, las placas, los racks, los sistemas de energía y parte del equipo de red que van dentro son diseñados, abastecidos y producidos por socios ODM/EMS como Celestica y Flex. Por eso, a medida que se disparan los pedidos de servidores de IA, no solo las empresas de marca, sino también las empresas ODM/EMS, llaman la atención.
Por qué ODM/EMS se ha vuelto más importante
En la era de AGENT AI, los servidores han dejado de ser simples ensamblajes y se han convertido en un sistema complejo que integra simultáneamente energía de alta densidad, redes de alta velocidad, refrigeración líquida y sustratos avanzados. En una estructura así, a las empresas de marca les resulta difícil asumir por sí solas toda la fabricación, y aumenta el valor de ODM/EMS, que puede hacer que la cadena de suministro avance con rapidez.
En particular, se considera que Celestica tiene un punto de crecimiento en su transición desde el EMS tradicional hacia un modelo ODM de alto valor añadido, y Flex también se está expandiendo hacia una estructura que va más allá de la fabricación para encargarse de adquisiciones, logística y soluciones de energía.
Empresas relacionadas
- HPE, DELL, SMIC, PENG, CLS, FLEX
10. Expansión del mercado de PC con IA
La razón principal por la que el mercado de PC con IA está creciendo es que la IA está pasando de ser una herramienta que simplemente responde a convertirse en un agente personal que se ejecuta justo al lado del usuario.
AGENT AI no solo resume documentos, sino que también tiene que organizar agendas, buscar archivos, resumir reuniones, ejecutar aplicaciones y recomendar tareas, por lo que solo con idas y vueltas a la nube tiene limitaciones.
Por eso, la IA ha empezado a entrar en el PC desde la nube. Al ejecutarse directamente en el dispositivo, se reduce la latencia, la información personal sale menos al exterior y algunas funciones siguen funcionando incluso sin Internet. En otras palabras, el AI PC es la plataforma de ejecución personal de la era de AGENT AI.
Dicho de forma sencilla, un AI PC es un PC que, además de CPU y GPU, incorpora una NPU para poder ejecutar la IA directamente dentro del dispositivo. La clave es que las funciones de IA generativa pueden procesarse en parte de forma local sin depender de la nube.
Gracias a esta estructura, los AI PC realizan con mayor rapidez y de forma más natural funciones como resúmenes de reuniones, traducción en tiempo real, organización de documentos, asistencia para la generación de imágenes y recomendaciones personalizadas. El Copilot+ PC de Microsoft se ha convertido en el principal punto de referencia de este mercado.
Cuota
Los AI PC ya están pasando de ser un nicho a convertirse en una tecnología de uso general. Según Gartner, la cuota de los AI PC se previó en <strong>2024año 15.6%, 2025año 31.0%, 2026año 54.7%</strong>, y el volumen de envíos en 2026año se presentó en 1cien millones 4,311diez mil unidades.
En el mercado, 2026es común la previsión de que los PC con IA superen la mitad de las ventas totales de PC en el año. ASUS también 2026los PC con IA en el año superarán el 50por ciento de las ventas totales, y 2027en el año podrían llegar a más del 60por ciento.
Nuevos PC con IA de NVIDIA, Microsoft y Arm
El cambio más importante es que NVIDIA ha entrado de lleno en el mercado de PC de consumo. NVIDIA, junto con Microsoft, presentó un nuevo superchip llamado RTX Spark, poniendo por delante PC con Windows para la era de los agentes de IA personales.
La clave de esta tendencia son los PC con IA de Windows basados en Arm. Microsoft creó primero, a través de Copilot+ PC, el estándar para los PC con IA, y el eje inicial fue Windows on Arm. A ello se suma la fuerte posibilidad de que NVIDIA también lance un procesador para PC basado en Arm, por lo que la combinación Microsoft + NVIDIA + Arm ha surgido como un nuevo eje para los PC con IA de nueva generación.
Empresas relacionadas
- ARM , NVDA, MSFT, DELL, ARM, QCOM
11. La importancia de NeoCloud
Qué es NeoCloud
NeoCloud es, en pocas palabras, un cloud de GPU exclusivo para IA.http://모델이다.biz Es un modelo que se centra en la computación con GPU y en las cargas de trabajo de IA, en lugar de una estructura de uso general como AWS o Azure que lo hace todo, y que permite suministrarlo más rápido.
Más que sustituir a los hyperscalers, se acercan más a un complemento que cubre la capacidad insuficiente de GPU. Por eso, cuanto más fuerte es el auge de la IA, más importante se vuelve NeoCloud.
Por qué ir hacia NeoCloud
La cuota de mercado de la nube se está desplazando de los hyperscalers a NeoCloud.
La razón para pasar de la nube a NeoCloud es que las nubes existentes han empezado a no seguir bien el ritmo de la IA.
La clave es la disponibilidad de GPU, la latencia, el coste y la especialización 4.
1) Disponibilidad de GPU: la nube tradicional tiene escasez de GPU
Impulsada por el auge de la IA generativa, la demanda de GPU se disparó, pero en los hiperescaladores tradicionales tardar en conseguir GPU llevaba 2~4 semanas, y en casos graves 3 meses o más.
Aproximadamente 3 de 1 empresas de IA sufren retrasos para conseguir GPU, y algunas deben esperar 90 días. AGENT AI realiza muchas llamadas de inferencia y la capacidad de respuesta en tiempo real es importante, por lo que este tiempo de espera llega a retrasar el propio proyecto.
2) Latencia: la nube tradicional es demasiado lenta
Aproximadamente 3 de 1 usuarios empresariales de IA respondieron que reducir la latencia fue el principal motivo por el que eligieron NeoCloud.
La nube tradicional está diseñada para gestionar cargas de trabajo de propósito general (servicios web, bases de datos, streaming, etc.), por lo que usarla para computación de IA de forma exclusiva provoca ineficiencia y latencia. En cambio, NeoCloud ofrece una infraestructura optimizada para la computación de IA, con arquitectura centrada en GPU y redes de alta velocidad (NVLink, InfiniBand).
3) Costes: la nube tradicional es cara
La proporción que señaló el coste como la principal razón para usar neocloud fue 13% , pero casi la mitad respondió que había migrado de un gran proveedor de nube tradicional a neocloud y había reducido los costes en más de 25% .
Las instancias de GPU de los hiperescalares tradicionales han sido criticadas a menudo por ser una estructura montada sobre infraestructura de uso general, de modo que usarlas solo para cómputo de IA hacía que el dinero se esfumara. De hecho, en el caso de las instancias NVIDIA H100 DGX, se señaló que la tarifa por hora de neocloud era aproximadamente un 66% más baja que la de los hiperescalares .
Además, los neoclouds tienen menos costes ocultos relacionados con el envío de datos y el almacenamiento, lo que hace mucho más fácil prever el coste total.
4) Especialización: la nube tradicional es de uso general, mientras que neocloud es exclusiva para IA
Neocloud es una estructura que ha eliminado los elementos innecesarios. Diseñada para hacer muy bien un pequeño número de tareas, ofrece capacidad de GPU con rapidez y está optimizada para cargas de trabajo de IA.
Mientras que la nube tradicional está diseñada para gestionar cargas de trabajo de uso general, las neoclouds incorporan de forma nativa una arquitectura centrada en GPU y una pila de software de IA. Esto les da una mayor competitividad que la nube general en cargas de trabajo de IA avanzadas basadas en GPU.
Empresas relacionadas
CRWV
CoreWeave es actualmente el actor destacado en las neoclouds. El mercado considera a CoreWeave el mayor operador de neocloud, y evalúa que crece rápidamente sobre la base de contratos a largo plazo y una gran cartera de pedidos.http://평가한다.finance.yahoo)
La fortaleza reside en la propia plataforma de nube de GPU. Más que simplemente alquilar centros de datos, la clave es una estructura full stack que también ofrece servicios gestionados de GPU y una capa de software para cargas de trabajo de IA.
NBIS — Nebius
Nebius es una de las 2026a finales de año, la tasa de ingresos anualizada hasta 70cientos de millones a 90miles de millones de dólares** .
Además, también obtuvo validación de los hiperescaladores al cerrar contratos con grandes clientes como Microsoft y Meta. Con la inversión de Nvidia añadida, aumentó la atención del mercado.
IREN
IREN comenzó originalmente sobre la base de una infraestructura de minería de Bitcoin, pero ahora se está transformando en una empresa de infraestructura de nube de IA y HPC. La clave es que ya cuenta con energía y terreno asegurados y los está convirtiendo rápidamente en infraestructura de GPU para IA.seekingalpha+1
En particular, el contrato de 5años con Microsoft llamó la atención del mercado. En el mercado, IREN se ve como un caso representativo de “convertir una infraestructura basada en energía en una nube de IA”.
APLD — Applied Digital
Applied Digital es un poco diferente de otros neoclouds. En lugar de operar directamente una plataforma en la nube, tiene ventajas en campus de centros de datos de IA con refrigeración líquida e infraestructura arrendada hay.
En otras palabras, APLD es menos una “empresa que vende GPU como servicio” y más un operador de infraestructura que construye y arrienda centros de datos para IA. A medida que AGENT AI crece, no solo las GPU sino también la energía, la refrigeración y los propios campus se vuelven escasos, por lo que este tipo de negocio también gana importancia.
12. cuello de botella de sustratos de IA
El contexto de que el sustrato aparezca como cuello de botella en AGENT AI es que, a medida que la IA no solo eleva el rendimiento de las GPU, sino que también procesa en tiempo real “inferencias continuas a gran escala”, la dificultad técnica y la presión de oferta sobre los sustratos aumentaron al mismo tiempo.
| Causa | Explicación |
|---|---|
| Mejora del rendimiento de cómputo → aumento brusco del caudal de señales | A medida que aumenta el rendimiento de cómputo de los semiconductores de IA, deben procesarse más señales con mayor rapidez, por lo que la dificultad de la tecnología de sustratos aumenta de forma pronunciada |
| Competencia en procesos avanzados → expansión de la competencia en empaquetado | A medida que la competencia en los procesos avanzados de semiconductores se expande hacia la competencia en empaquetado, el cuello de botella existente de CoWoS se desplaza hacia FC-BGA, ABF y MLB de alta capa |
| Inferencia masiva en tiempo real → demanda no lineal de sustratos y componentes | Como AGENT AI implica muchas llamadas repetidas, conversaciones continuas y planificación en varios pasos, la demanda de GPU, MLCC, PCB y sustratos no aumenta en proporción simple, sino en múltiplos |
| Choque entre sustratos HBM y líneas de producción | Al chocar los sustratos HBM con las líneas de producción de PCB pequeñas (mSAP), los plazos de entrega han pasado de 6 semanas a 6 meses, extendiendo los cuellos de botella de la cadena de suministro por todas partes |
| Periodo de certificación de 6+ meses al cambiar de proveedor | Al cambiar de proveedor de sustratos y componentes, el periodo de certificación requiere al menos 6 meses, por lo que es muy probable que el cuello de botella persista de forma estructural |
| Lento ritmo de expansión de packaging, underfill, pruebas, comunicación óptica y tarjetas de sonda | El ritmo de expansión de los principales proveedores de componentes es más lento, por lo que los cuellos de botella se extienden por todas partes, y los tramos de cuello de botella emergen como áreas con poder de fijación de precios |
| Broadcom señala restricciones en la cadena de suministro de IA | Broadcom identifica la tecnología de proceso avanzado de TSMC, los láseres y los PCB para transceptores ópticos como restricciones clave, y el plazo de entrega de los PCB para transceptores ópticos ha pasado de 6 semanas a 6 meses |
Los servidores de IA no solo han visto una mayor capacidad de cómputo de los chips, sino también aumentos simultáneos en el tamaño del paquete, la densidad del cableado, el consumo de energía y la velocidad de la red, lo que ha elevado de forma pronunciada las especificaciones de sustratos y componentes. Como resultado, los cuellos de botella se están desplazando en este orden: empaquetado CoWoS → ABF/FC-BGA → MLB/CCL → MLCC, y los beneficios se concentran especialmente en las empresas que pueden manejar materiales de alta capa, gran área y baja pérdida.
FC-BGA / ABF / sustrato de vidrio
-
FC-BGA: sustrato de encapsulado de alta densidad, un sustrato de alto rendimiento que monta chips semiconductores dándoles la vuelta (Flip-Chip), conecta GPU, CPU y chips de IA al sustrato, y se encarga del procesamiento de alta potencia y alta señal
-
Sustrato ABF: el material aislante central de FC-BGA, un material de película que crea la capa aislante en los sustratos FC-BGA, un material clave que hace posible la estructura de alta capa de los sustratos FC-BGA, y no es posible fabricar FC-BGA de alto rendimiento sin ABF
-
Sustrato de vidrio: resuelve las limitaciones de los sustratos orgánicos (ABF) en alabeo, calor y precisión
El trasfondo clave del cuello de botella de FC-BGA es que, a medida que las GPU de IA y los ASIC crecen, aumentan al mismo tiempo el número de capas y el área del sustrato, mientras que la capacidad de expansión en la gama alta no logra seguir el ritmo de la demanda.2026Mirae Asset Securities analizó que, a medida que Hopper da paso a Blackwell, Rubin y Feynman, la demanda de FC-BGA y el número de capas de ABF seguirán aumentando, y que el FC-BGA para servidores probablemente pasará a un mercado favorable para los proveedores a partir de entonces.
FC-BGA: mayor tamaño de las GPU/ASIC de IA, aumento del número de capas, velocidad de expansión limitada
Sustrato ABF: traslado del cuello de botella tras la relajación de CoWoS, fuerte aumento de la demanda de ABF de muchas capas
Empresas relacionadas
-
Samsung Electro-Mechanics: beneficiaria representativa que posee a la vez FC-BGA y MLCC
-
Daeduck Electronics: FC-BGA para servidores y semiconductores
-
LG Innotek: se espera una mejora del ASP por su entrada en FC-BGA para CPU
Entre las cotizadas en Estados Unidos, es más realista centrarse en packaging, ensamblaje y sustratos de alta fiabilidad que en un productor puro de ABF
-
AMKR: beneficio por la expansión del packaging avanzado
-
SANM (Sanmina): beneficio por el ensamblaje de backplanes y sustratos para la infraestructura de servidores de IA
-
Sustratos de vidrio: SKC, Samsung Electro-Mechanics, Chemtronics / INTEL, GLW
PCB·MLB·CCL
-
PCB: placa de circuito impreso, la placa base que conecta varios componentes en dispositivos electrónicos
-
MLB: placa multicapa, una placa formada apilando PCB en múltiples capas (normalmente 4 capas o más), y para los servidores de IA, son esenciales las MLB de alta multicapa de 18 capas o más
-
CCL: laminado recubierto de cobre, el material base utilizado para fabricar PCB, que determina la pérdida de señal y la estabilidad de voltaje. Para los servidores de IA, se necesita CCL de alto rendimiento y bajas pérdidas de la serie M8→M9, y se producen cuellos de botella por las restricciones de suministro de fibra de vidrio de bajo CTE y lámina de cobre HVLP
El cuello de botella en PCB y MLB se debe a que la aceleración de los servidores de IA, los conmutadores y los equipos de red está impulsando rápidamente la demanda de MLB de alta multicapa de 18 capas o más, al tiempo que aumentan la carga de procesos y la dificultad del rendimiento. En particular, Mirae Asset Securities señaló que la MLB de 18 capas o más será el segmento con la mayor tasa de crecimiento en 2024~2029 y explicó que la expansión de los métodos de apilado múltiple es clave para el aumento del ASP
El cuello de botella de la CCL es un cuello de botella de material upstream de la PCB. Con la expansión de los servidores de IA y de las redes 800G·1.6T, la demanda de CCL de gama alta con características de baja constante dieléctrica y bajas pérdidas (serie M8·M9) ha aumentado estructuralmente, y los cuellos de botella han surgido porque también se han sumado las restricciones de suministro de materias primas como la fibra de vidrio de bajo CTE y la lámina de cobre HVLP. En otras palabras, cuanto más rápida se vuelve la PCB, la estructura pasa a ser una en la que escasea no la placa laminada simple, sino una “cadena de suministro capaz de absorber CCL de alto rendimiento”
Empresas relacionadas
-
Sustratos PCB: SYMC, TLB, Korea Circuit, TTMI
-
Sustratos MLB: ISU Petasys, Daeduck Electronics
-
CCL: Doosan, Solus Advanced Materials, Lotte Energy Materials
**TTMI (TTM Technologies) es la única empresa de sustratos PCB que fabrica en Estados Unidos
MLCC
- MLCC: condensadores ultracompactos (componentes de almacenamiento de carga) formados por capas de cerámica, estabilización de la energía + filtrado de señales + prevención de cambios bruscos de voltaje
El cuello de botella de los MLCC está directamente ligado al aumento del consumo de energía en los servidores de IA. A medida que crece el consumo de energía de las GPU y los ASIC, el volumen instalado de MLCC de alta fiabilidad y ultraalta capacidad aumenta de forma no lineal, y aunque las tasas de utilización de las empresas líderes se acercan a 90~100%, el Capex se mantiene de forma conservadora, por lo que la oferta no puede ampliarse con rapidez. Por ello, los MLCC no deben verse como un simple componente auxiliar, sino como un cuello de botella para la estabilización de la energía.
Empresas relacionadas
-
Samsung Electro-Mechanics: PCB (FC-BGA) + MLCC gran capitalización con doble catalizador, en los racks de nueva generación de NVIDIA PCB +233%, MLCC +182% de aumento simultáneo
-
LG Innotek: producción simultánea de PCB + MLCC, doble catalizador
Tecnología de encapsulado de próxima generación
- Límite de los procesos finos → expansión del rendimiento mediante el encapsulado
-
A medida que los procesos semiconductores de nodo fino (3nm, 2nm) se acercan a su límite, el método de ampliar el rendimiento y la eficiencia energética mediante el empaquetado surge como una estrategia clave
-
Tecnologías de empaquetado como CoWoS de TSMC (Chip on Wafer on Substrate) se están consolidando como una ventaja competitiva central en los semiconductores de IA
- Chip de IA de mayor área → menor número de chips por oblea
-
Hopper 30 unidades → Blackwell 16 unidades → Rubin 6 unidades, y las obleas de 12 pulgadas 1 reducen drásticamente el número de chips puros por oblea
-
Para empaquetar eficientemente chips de gran área, tecnologías de nueva generación como CoWoS y FO-PLP (Fan-Out Panel Level Packaging) son esenciales
- Integración de HBM → mayor complejidad de empaquetado
-
Dado que la memoria de gran ancho de banda (HBM) debe integrarse en un solo paquete con chips de IA, la etapa de encapsulado actúa como cuello de botella de la cadena de suministro
-
La CAPA de CoWoS de TSMC no puede seguir el ritmo de la demanda 2024~2025 y se intensifica el cuello de botella del encapsulado
- Integración de múltiples chips → se requieren interpositores y capas de redistribución
-
Como los chips de GPU, CPU, memoria y red deben unirse en una sola estructura de encapsulado, son indispensables materiales y procesos como interpositores de silicio, capas de redistribución y underfill
-
A medida que tanto el FC-BGA convencional como los interpositores de silicio muestran sus límites al mismo tiempo, surgen alternativas de nueva generación como los sustratos de vidrio
- Transición del cuello de botella del encapsulado → cuello de botella del sustrato
-
2026La expansión agresiva de la capacidad de CoWoS de TSMC ha aliviado el cuello de botella del empaquetado
-
Sin embargo, el cuello de botella se ha desplazado a ABF·FC-BGA·MLB de alto número de capas·CCL de alto rendimiento·MLCC
El núcleo de la competencia en semiconductores de IA está ahora en el empaquetado y los sustratos más que en el chip en sí.
-
Alivio del cuello de botella de CoWoS → aparición de cuellos de botella en FC-BGA·ABF·MLB de alto número de capas·CML de alto rendimiento·MLCC
-
Las tecnologías de empaquetado de nueva generación (CoWoS, FO-PLP, sustratos de vidrio) son clave para la integración de chips de gran superficie·HBM
3DIC Noticias recientes: el nuevo cuello de botella de los semiconductores de IA, el empaquetado avanzado (2026)
3DIC es una tecnología que apila chips de arriba abajo y los agrupa en un solo paquete. La corta distancia entre chips acelera el intercambio de datos y reduce el consumo de energía. CoWoS y SoIC de TSMC, Foveros de Intel e I-Cube de Samsung son los métodos de implementación de cada empresa. HBM también es un 3método DIC para apilar matrices de DRAM.
El tamaño del mercado se está expandiendo rápidamente. Mordor Intelligence dijo que el mercado 2.5D·3DIC creció de 2025 a 112 mil millones de 4,000 millones de dólares, y para 2026 se espera que alcance 148 mil millones de 4,000 millones de dólares. Previó un crecimiento anual promedio de 2031% hasta 32, hasta alcanzar 451 mil millones de 9,000 millones de dólares. La demanda existe, pero la oferta no logra seguirle el ritmo. Un análisis dice que Nvidia usa el 60% de la capacidad de CoWoS, y las líneas de CoWoS se han convertido en un cuello de botella.
TSMC dijo que elevaría la producción de CoWoS a unidades de oblea mensuales de 2026 para finales de 15, y está destinando una parte importante de su gasto de capital de 520 mil millones a 560 mil millones de dólares a empaquetado. El problema son los límites técnicos. El rendimiento de HBM de 12 capas3 se mantiene en el rango bajo del 50%, y el rendimiento de alrededor de 8~70% en 80 capas cae por debajo del 12% al pasar a 50 capas, lo que lleva el costo por paquete a casi duplicarse. La potencia del paquete supera los 1,400~2,000 vatios en chips de clase Blackwell y Rubin, por lo que resulta difícil de manejar con la refrigeración existente.
La automatización del diseño sigue siendo un área inconclusa. Cadence lanzó Millennium y Allegro X AI en 2026 y 4, pero dijo que la verificación final (signoff) sigue siendo un dolor para el cliente. Los movimientos para ampliar el ecosistema son claros. IC-Link, dependiente de imec, se unió a la 3DFabric Alliance de TSMC, e Intel presentó su hoja de ruta EMIB-T. Samsung está desarrollando un diseño que busca sortear el cuello de botella de TSMC con una estrategia llave en mano que combina foundry, memoria y empaquetado.
Desde la perspectiva del inversor, la clave es simple. La velocidad a la que se resuelva el cuello de botella de CoWoS es un indicador adelantado de los envíos de GPU y de la demanda de HBM. 3Los rendimientos de DIC deben subir para que se afloje la estructura de altos costos y se acelere el suministro de servidores de IA. La HBM de Samsung4 y si se consiguen pedidos de empaquetado llave en mano son variables principales para las acciones nacionales de semiconductores en 2026-2027.
Empresas relacionadas
-
ASE: la mayor empresa especializada en empaquetado avanzado del mundo, con una tecnología alternativa a CoWoS que compite con CoWoS de TSMC
-
AMKR: beneficiada por la expansión del empaquetado avanzado, beneficiada por empaquetado y ensamblaje de alta fiabilidad con base en Norteamérica
Resumen
Así, en este punto de inflexión hacia AGENT AI, se puede ver que han surgido numerosos cuellos de botella.
Ahora las empresas ganan dinero con la IA, y dentro de las empresas AGENT AI sustituye a las personas.
Las grandes tecnológicas están aumentando con decisión la inversión en CAPEX, como la ampliación de capital de Google y la inversión de Meta, y esta inversión no se puede detener.
Aquí, sería bueno encontrar mejor una empresa de palas y picos que una empresa minera y llevarla bien como valor líder.
Mientras se sigue impulsando a los sectores líderes actuales, las comunicaciones ópticas y los semiconductores de memoria, como las empresas del siguiente cuello de botella atraen flujos y / si rompen al alza técnicamente, creo que sería bueno aumentar más la posición.
Preguntas frecuentes
En el punto de inflexión de los agentes de IA, ¿cómo crea la escasez de suministro de GPU un cuello de botella para los beneficios empresariales?
La escasez de suministro de GPU limita la capacidad de cómputo, eleva los costes y ralentiza la adopción de productos y la expansión de los ingresos.
¿Por qué la caché KV se convierte en un cuello de botella en los agentes de IA?
La caché KV procesa millones de tokens en tiempo real, supera la capacidad de memoria y deja la GPU en espera.
¿Qué impacto tiene la latencia de inferencia en tiempo real en la adopción de productos de agentes de IA y cómo se puede reducir?
La latencia de inferencia en tiempo real retrasa la adopción del producto y reduce las oportunidades de ingresos. Se mitiga con memoria de gran capacidad y bajo costo (HBF, NAND), redes (comunicaciones ópticas, CPO) y optimización de la caché.
¿Qué es HBF y qué significa para el mercado de memoria?
HBF es una memoria flash de alto ancho de banda basada en NAND que compensa las limitaciones de capacidad de HBM en 8~16veces. Si se comercializa, se convierte en un factor que mejora la rentabilidad gracias a la demanda de cachés de gran capacidad.
Entre NAND y HDD, ¿cuál es más importante en la infraestructura de IA?
Depende del uso. NAND es importante para caché KV de gran capacidad y bajo coste, mientras que HDD es importante para el almacenamiento a largo plazo de datos de entrenamiento e inferencia.