Bullstory Research 2026年7月7日
AIエージェントの転換点におけるボトルネック
要点
KVキャッシュがメモリのボトルネックを生み、2026年のHBF商用化がそれを解決する分岐点です。HBFはHBM容量を 8~16倍に増やし、NAND需要を急増させます。SK hynixが標準化を主導。
AI推論への転換により、NANDとSSDは単なる補助記憶装置から、AIインフラの中核資源へと変わった。AIサーバー一台に必要なストレージは従来のサーバーの 8~10 倍に増え、KV CACHEなど大容量・リアルタイムアクセス向けのエンタープライズSSD需要が急増する。NAND需要は年間 20~22 %増加するが、設備転換は遅く、供給圧力が続く。
1. AGENT AI の登場
AGENT AIは、目標を与えると自ら計画を立て、ツールを選び、実行し、結果を評価するAIだ。
従来のLLMはチャットボットにすぎなかった。人の代わりというより、支援役に近かった。
しかし、AGENT AIは直接コンピューターに入り、人のように作業し、業務をこなす。
そしてLLMとは異なり、利益を生む。競争を生き残り収益化するために、AI企業はAGENT AIモデルにすべてを懸けている。
AIバブルはまだ初期段階だ。CAPEX投資を減らすことはできない。埋没費用が生じるためだ。
AGENT AIはLLMよりはるかに多くの仕事をするため、無数のボトルネックが生じる。
電力(SOFC、ガスタービン) / CPU、GPU、TPU、NPU、HBM / メモリ DRAM、NAND、HDD / 基板、銅 * 光通信などのインターコネクト
/パワー半導体、AI PC / データセンター建設、ネオクラウド / まで、無数にボトルネックが発生している。
2. なぜ今AGENT AIなのか?
従来のAIは、質問すると答える一回限りのチャットボットであり、人が毎回指示しなければならない。
AGENT AIは、目標 → 計画 → 実行 → フィードバック → 繰り返しによって自ら判断し、行動する。
AGENT AIは、24時間自動化されたデジタル労働者であり、反復業務の削減、人件費の節約、売上機会の増加によって、直接的な収益創出を行う。
企業需要が爆発 "実際のコスト削減、売上増加"
-
反復業務の自動化: サポート、営業、財務、プロダクトなど全分野でAI社員の需要
-
24 時間 AI スタッフ: 人がいない時間でも業務が進む → 売上機会の増加
-
実際のコスト削減: 導入企業のうち、83%が反復業務を削減, 76%が生産性向上を経験
収益への影響: 導入費用 < 削減された人件費 + 増加した売上 → ROI(投資収益率)が明確
3. メモリ(DRAM·NAND)のボトルネック
KV CACHE: メモリボトルネックの核心要因
KV CACHE(Key-Value Cache) は AGENT AI の推論過程におけるメモリのボトルネックを生む主要因である。
KV CACHEとは何か。AI が文章を生成するとき、以前に計算したKey と Value の値をメモリに保存し、再計算せずにそのまま使う技術。
問題: AGENT AI は数百万トークンをリアルタイムで処理しなければならず、KV CACHE の容量がメモリの限界を超えると、GPU はただ待つしかない。これが"メモリーウォール (Memory Wall)"である。
結果: GPU の演算速度は爆発的に増えたが、メモリがその速度でデータを供給できなければ、高価な GPU が無駄になる。
NAND の重要性が急浮上した背景
DRAM ベースの HBM だけでは容量の限界(192GB)とコスト負担が大きい。
NAND(NANDフラッシュ)が重要になっている理由:
-
容量: DRAMと比べて10倍の保存領域
-
コスト: HBMと比べて8~16倍安い
-
不揮発性: 電源が切れてもデータを保持
キーポイント: AI推論時代では、KV CACHE を収める大容量・低コストのメモリが不可欠 → NAND需要が爆発.
AI推論への転換がNAND·SSD市場を変える構造 (2024~2026)
OpenAIのo1公開(2024年9月)を起点に、AI技術の中心は学習から推論へ移った。この一度の構造的な移動が、ストレージ需要の地図を変えた。
推論段階では、モデルがリクエストごとに大規模データを素早く読み込む。KVキャッシュとベクトルデータベースへのアクセスが常時発生し、高速・大容量のエンタープライズSSD需要がGPU需要とともに急増した(TrendForce、2026年5月)。
以下が目に見える変化だ。 2026年にAIサーバー一台に必要なストレージは、従来サーバーの8〜10倍だ。NAND需要は年率20〜22%増える一方、供給は15〜17%程度にとどまる(Commercial Times、oscoo分析、2026年)。需要は速いが、生産・設備転換はその速度に追いつけない。
NAND供給が減る逆説
需要が急増しているのに供給が追いつかない理由は、業界の設備配分にある。SamsungとSK hynixはNANDラインをHBM向けに転換している。HBMのマージンが<strong>60%</strong>を超えるためだ。Samsungのウエハー生産量は2025年490万枚 → 2026年470万枚に減ったという報告もある。NAND設備投資は前年同期比5%増にとどまった。Micronは新工場が2027年以前には稼働できないと述べた。SK hynixは2025年10月の業績発表で、2026年物量がすでに完売したと明らかにした(oscoo、storageswiss.com、2026年)。
この構造的な移動は、短期的な供給不足を深刻化させる。需要はデータセンター・推論中心に再編される一方、供給は高収益のHBM生産へ向かっている。結果として、エンタープライズSSDの価格と在庫への圧力が強まる。
SSD価格と市場の変化 — 今起きていること
価格はすでに反応している。TLC 1テラビットNANDの単価は 2025年半ばの 4.80ドルから 2025年末の 10.70ドルへと、 6か月で倍になったという発言があった(Phison CEO、Tweaktown、2025年 11月)。
コンシューマー向けの 1TB SSD価格も上昇した。 2025年初に 45~60ドルだった製品が 2025年 9月以降 70~90ドル以上に上昇した。SanDiskは 2026年初にWD Black SN8100 4TBモデルの価格を 549.99ドル → 1,289.99ドルに引き上げた事例を公開した(Kingspec分析、kitpa.org、2026年 2月)。
Micronは 2025年 12月に、コンシューマーブランドであるCrucial事業を終了することを決めた。 2026年 2月からコンシューマー向け新製品の出荷を停止し、生産のすべてをAI・エンタープライズ用途に振り向けた(oscoo、2026年)。
エンタープライズSSDがモバイルを追い抜く歴史的転換
2026その年は、データセンターが初めてモバイルを上回り、NAND の最大需要先になる年になる可能性が高い。サンディスクの CEO は 2026年 1月の決算発表で、データセンター向け NAND 容量の成長率を「年間 60%台後半」と示した。マイクロンの 2026会計年度の NAND 売上高は、ウォール街では前年同期比 178%増の約 236億ドル と見積もられている(サンディスク決算発表、Zacks、 2026年)。
TrendForce は、世界の NAND フラッシュ市場規模の予測を 2026年に 2,706億ドル へ上方修正した。前年同期比 281%成長 という数字だ。 2027年には 3,794億ドル までさらに拡大すると予想した。もっとも、実質的な供給拡大は 2027年末〜2028年以前 までは難しいという業界の見方もある(TrendForce、 2026年 5月)。
結論的な見方:AI 推論がストレージ需要の中心となるにつれて、NAND と SSD は単なる補助記憶装置から、AI インフラの中核資源へと変わった。需要の急増に比べ、設備転換は遅い。これにより、エンタープライズ SSD と大容量 NAND は、メモリ・ストレージ分野で短期的かつ構造的な投資ポイントとなった。
HBF 技術:HBM の容量限界を 8〜16倍突破
HBF(High Bandwidth Flash、高帯域幅フラッシュ)は、HBM を代替するのではなく、HBM の容量限界を補完する次世代メモリだ。
HBF の核心説明
-
素材: NANDフラッシュ(DRAMベースのHBMとは異なる)
-
容量: HBMに比べて8~16倍大きい(GPUあたり最大4TBまで可能)
-
速度: HBMの80~90%程度(十分に速い)
-
コスト: 同程度のコストで8~16倍の容量
-
役割: HBMはキャッシュ(高速データ処理)、HBFは図書館(大規模AIモデルの保存)
HBFの技術構造
-
3三次元積層NAND: 複数のNANDダイを縦方向に積み重ね、単一パッケージ化
-
TSV(シリコン貫通電極): 各NANDダイを垂直に接続し、帯域幅を拡大
-
CBA(ウェハーボンディング): メモリセルと回路を直接結合し、性能を向上
-
複数サブアレイ: 同時アクセスで読み出し帯域幅を最大化
商用化
-
2026 後半: HBFメモリの初回サンプルを提供
-
2027 年初に: HBFを搭載したAI推論デバイスの初回サンプル
関連企業
-
SK Hynix: SanDiskとMOUを締結し、HBFの標準化を主導
-
Samsung Electronics: DRAMとNANDの両方を生産し、HBFの機会を持つ
-
SanDisk(Western Digital): HBF技術の開発を主導
キーポイント: 2026 年のHBF商用化は、メモリ市場の収益性急増の重要な変数。
HDD需要の急増: 大容量保管に不可欠
HDD(ハードディスク)はSSD に比べて 5~8 倍安く、大容量保管に最適だ。
HDD需要急増の背景
-
AIデータ量が 3 倍急増(2023~2028, 400ゼタバイト)
-
約 80% はコスト効率のためHDDに保存される
-
学習・推論データのアーカイブ: 保存が必要 → HDDはコストパフォーマンスに優れる
HDD市場の最近の動向
-
HDD価格: 供給価格 4% 上昇、実際の販売価格 20% 上昇
-
HDD納期: 最大 1年超 まで延長(品薄現象)
-
2026年: 出荷量 反発
-
2028年: 出荷量 2億台 突破、単一最大容量 60TB に到達
関連企業
-
Western Digital: HDD世界 1以上、全製品を即時値上げ
-
Seagate: HDD 2以上、値上げ計画を発表
結論
KV CACHEはメモリのボトルネックの核心要因であり、**HBFはHBMの容量限界を8~16倍突破する次世代AIメモリだ。
NANDは大容量・低コストで重要性が急浮上し、HDDは大容量保存に不可欠だ。(SSD価格が上がるのでHDDも恩恵)
2026年HBFの商用化がメモリ市場の収益性急増の核心変数。SK hynix・Samsung Electronics・SanDiskが主導。
4。ネットワーキングのボトルネック
AGENT AIは一人で動くわけではない。 何千ものGPUがチームとして協力し、ひとつの大規模モデルを学習または推論する。
問題: GPUの演算速度は爆発的に増えたが、 GPU同士をつなぐネットワーク速度がそれに追いついていない現象。
結果: GPUが データを待つ時間が増え、 高価なGPUが無駄になる。これが "ネットワーキングのボトルネック" である。
GPU接続速度が GPU演算速度に追いつかなければ、 AIインフラ全体が詰まる。
関連企業
-
CRDO: AIアクセラレータ間の超高速接続チップ 核心: GPU間のデータ伝送のためのインターフェースチップ、PAMの前段4 高速トランシーバー
-
ALAB: チップに光通信を統合するCPOチップ、GPU間の光通信接続ソリューション 核心: CPO技術で先行, チップ + 光モジュール統合を主導
-
ANET: AIデータセンター向けの 400G/800Gスイッチ、高帯域幅イーサネットスイッチ 核心: CLSの主要顧客, AIデータセンターネットワーキングを主導
-
CLS: 高帯域幅スイッチ、ホワイトボックススイッチ、AIサーバーラック・ネットワークスイッチ製造の中核(CPOベースのスイッチ製造)
光通信が注目される背景
光通信は、光を使ってデータを送信する技術で、配線に比べてはるかに高速で、消費電力が少ない。
光通信が注目される理由:
-
高速: 毎秒数テラビット(Tbps)の送信が可能
-
低消費電力: 配線に比べて50電力を節約
-
低遅延: 信号の遅延を最小化
-
大容量: AIデータセンターでの巨大なデータ送信に必須
重要ポイント: AIデータセンターで数千のGPUを接続するには、光通信が不可欠だ。
MRVLの成長
3Nvidiaとの契約後、非常に急速に成長し、Nvidiaのエコシステムに入り、最近Jensen Huangは 1同社について発言した
-
AIサーバー間のデータ伝送量が爆発的に増加 → 800G·1.6T Ethernetスイッチ の需要が急増
-
AIラック間で光通信が必要 → Marvellは光トランシーバーの主要供給元
-
Broadcomとともに、Ethernetスイッチの 2大手
-
MarvellはAIデータセンターネットワークの中核, 基板のボトルネック構造におけるネットワーク・光通信のボトルネックを代表する企業
CPO技術: ネットワークのボトルネック解決の鍵
CPO(Co-Packaged Optics)は、光通信デバイスをチップと一つのパッケージに組み付けることで、データ伝送の遅延と消費電力を同時に減らす技術である。
従来方式:
-
光通信モジュールがチップと分離
-
データが配線を伝ってモジュールまで移動 → 電力損失、遅延が発生
CPO方式:
-
光通信モジュールがチップと一つのパッケージ(物理的に統合)
-
データが直接接続される → 電力 50%削減、遅延を最小化
CPO技術の進捗状況
| 項目 | 内容 |
|---|---|
| 帯域幅 | 既存の 400G → 1.6T以上 |
| 電力 | 50%削減 |
| 商用化 | 2026年 本格導入 |
| 市場 | 2028年 100億ドル以上 |
関連企業
-
LITE : 光トランシーバー、 レーザー、検出器など光通信の中核部品中核: 光通信モジュール供給, CPO対応の光デバイス生産
-
COHR : 高性能光トランシーバー: 800G/1.6T光通信モジュール、光通信用レーザー中核(高帯域幅光デバイス, CPO光モジュール供給)
-
AAOI : 400G/800G光トランシーバー: AIデータセンター向け、高速イーサネットソリューション要点: 光通信モジュール供給, AIサーバー・ネットワーキング
-
MXL : PPM: 光通信信号処理チップ、ネットワーキング向けアナログ部品要点: 光通信信号処理, ネットワーキングチップ
-
TSEM : 半導体パッケージング・チップ統合、ウェーハボンディング技術、 3三次元ICパッケージング: チップを垂直に積層する技術
-
VIAV : 光通信ネットワークのテスト・計測、CPOテスト装置
-
POET : 光インターポーザー, Optical I/O: AIアクセラレーター間の光通信接続要点 (CPO技術の先行確保, チップ + 光モジュール統合)
-
KEYS : 通信計測装置: 光トランシーバー性能検証、高速インターフェーステスト: 112G PAM4 チェック
-
GLW : 光ファイバー: データセンター間の超高速接続、ガラス基板: CPOベースのチップ統合
光デバイス材料: レーザー、検出器などの光通信部品 中核(光通信材料、CPO用ガラス基板の供給)
5. CPUのボトルネック
AGENT AI時代のCPUのボトルネックは、「GPUだけ速ければ終わりではない」と要約できる。エージェント型ワークロードでは、推論そのものよりも オーケストレーション、メモリ管理、データ前処理、ツール実行、スケジューリング といったCPU的な作業が増えるため、CPUの重要性が再び高まった。
初期の生成AIは「GPUがすべて」のように見えたが、AGENT AIになるにつれてCPUが担う仕事が急増した。AIエージェントはモデルを呼び出すだけでなく、複数の工程を調整し、外部ツールを呼び出し、データを移し、結果を再びつなぎ合わせる必要があるため、CPUがシステムの交通整理役をはるかに多く担うようになった。
重要なのは、CPUが遅いとGPUが遊んでしまうという点だ。NVIDIAもVera CPUを紹介し、エージェンティックAI、強化学習、データ処理、オーケストレーションはCPU集約的な作業だと説明し、Veraはx86 CPUに対してエージェント業務の完了速度を80%高めると明らかにした
なぜ今が転換点なのか
市場はすでにCPU需要の構造が変わりつつあると見ている。一部の業界分析では、従来のLLM展開におけるCPU比率はサーバー需要の約15%程度だったが、AGENT AIが普及すれば、その比率は50%程度まで拡大し得るとされた。
この変化は単なる性能競争ではなく、アーキテクチャの転換も伴う。ArmはデータセンターCPU売上高ベースのシェアが2025年に50%まで跳ね上がり得ると明らかにし、AI ASICサーバー向けホストCPU市場では、2029年初にArmベースCPUが90%を占め得るという見通しも出た。
関連企業
-
AMD : AGENT AIでCPU需要が再び拡大する局面で、AMDはサーバーCPUのシェアを拡大しており、EPYC製品群は引き続きIntelのシェアを奪っている
-
ARM: Arm 自体と Arm ベースのサーバー CPU を使うハイパースケーラーが恩恵を受ける可能性が高い。Arm CPU は電力効率に優れており、AI サーバーではホスト CPU もしくはトラフィックコントローラーの役割が大きくなっているため、構造的なシェア拡大が見込まれる。
-
NVDA (Vera Rubin)
-
INTC
6. Vera Rubin の登場
Vera Rubin (Vera Rubin) は NVIDIA の次世代 AI プラットフォームであり、単に速いチップではなく、AI ファクトリー全体をゼロから再設計したシステムだ。
-
3.3 の性能向上: Blackwell と比べて、3.3 倍の性能、3.5 倍の学習、5 倍の推論の向上
-
HBM4 搭載: 6世代の高帯域幅メモリ(SK hynix と Samsung Electronics が独占供給)、8 個の HBM4スタック による超高帯域幅
-
Vera CPU の統合: 既存の Grace CPU を引き継ぐ、徹底的に AI 専用設計の CPU。AI エージェントのツール呼び出し、コード実行、データ処理を担う
-
ラックスケール・アーキテクチャ: NVL72(72 個の CPU + 144 個の GPU) → ひとつのスーパーコンピュータ
-
電力効率: Blackwell と比べて、トークン当たりの計算コストが大幅に低い
Vera Rubin がもたらす CPU 市場競争
Vera Rubinは、NVIDIAのCPU分野への直接参入を示すものであり、86x(AMDとIntel)対Armの競争にNVIDIAが加わる構造的な変化を生み出す。
競争構図
-
NVIDIA vs AMD vs Intel: Vera CPUはAIエージェント・強化学習・データ処理専用に設計されており、既存のx86と比べて50%高速、2x倍の効率性
-
AMDのシェア拡大: 2026年 1四半期 x86サーバーCPUシェアが<strong>33.2%</strong>まで上昇し、Intelは55% → 低下
-
Armの急成長: ArmのサーバーCPUは2025年 50%を達成し、2029年 90%が予想される
Vera Rubinは、GPU中心のAIインフラからCPU+GPUのコ・デザインへの移行を示すシグナルだ。
NVIDIAのCPU領域への直接参入で86x vs Arm vs NVIDIA3半導体戦が始まる
関連企業
-
SK Hynix、Samsung Electronics、Micron : HBM4供給
-
CLS : ODM製造、AIサーバーラック・ネットワークスイッチ製造、 1上
-
FLEX : 電源管理、冷却、 110kW電源シェルフ、液体冷却CDU供給
-
Hanmi Semiconductor : HBMパッケージング装置
-
HPSP: サーバー製造、Vera Rubin NVL72対応サーバー供給
-
EO Technics: HBM4テスト装置
-
CRWV, NBIS: ネオクラウド企業のCoreWeaveとNebiusはVera Rubinを搭載予定(GTC 2026)
7. AIはクラウドの外へ出ている
AGENT AIは、単なる応答型AIではなく、リアルタイムで判断し実行しなければならない。だからこそ、クラウドだけに依存することの限界が明確になった。主な理由は、遅延、セキュリティ、コストである。
クラウドに毎回データを送ると応答が遅くなり、機密情報が外部に出てしまい、リクエストが増えるほど利用料も大きくなる。だから AI は、データがある場所、機器がある場所、現場がある場所へと、ますます移動している。
オンプレミスAI
オンプレミスAIとは、企業が自社サーバーや社内データセンター内でAIを直接動かす方式だ。金融、医療、公共のようにデータ流出が致命的な分野で特に重要だ。
重要なのはセキュリティとデータ主権だ。データを外部クラウドへ送らないため規制対応がしやすく、社内文書・顧客情報・設備データのような機密データもより安全に扱える。
関連企業
-
Dell、HPE: 企業内にAIサーバーを構築する代表的なインフラ企業だ。
-
CLS, FLEX: DELL·HPEの背後で、実際のサーバー、電源、ネットワーク機器を製造する製造パートナーである。
-
BiMatrix, Konan Technology, Synapsoft: 国内のオンプレミス型AIソフトウェア・LLM需要の恩恵が期待される企業である。
デバイス内AI
デバイス内AIは、スマートフォン、PC、ノートPC、車のような端末の中で直接AIを実行する方式である。クラウドを経由しないため高速で、オフラインでも動作し、個人情報保護に有利である。
この方式が重要になった理由は、AGENT AIがユーザーのすぐそばで即座に反応する必要があるためだ。AI PC、AIスマートフォン、ウェアラブルのような個人端末がAIの最初の実行空間になるにつれ、デバイス内AIは急速に拡大して[http://있다.semiconductor.samsung).
主要な恩恵銘柄
-
Apple、Samsung Electronics、LG Electronics: スマートフォン、PC、家電でオンデバイスAIを直接普及させる代表的な企業。http://기업들이다.blog)
-
Qualcomm: 低電力AI演算向けチップとNPUエコシステムの中核企業
-
SK hynix、Samsung Electronics: モバイル・AI PC向け低電力メモリ需要拡大の直接的な恩恵銘柄。http://수혜주다.blog)
-
Openedges Technology、Chips&Media、Jeju Semiconductor: オンデバイスAI向けIP、映像処理、低電力メモリ関連の恩恵銘柄としてよくまとめられる。
エッジAI
エッジAIとは、工場、カメラ、ロボット、車両、医療機器のようにデータが生成される現場で、AIを直接動かす方式だ。重要なのは、クラウドに送る前に現場で即時に判断する点である。
エッジAIが重要なのは、リアルタイム性にある。自動運転、産業自動化、スマートカメラ、ロボットは、数秒ではなくミリ秒単位の応答が必要で、クラウドへの往復を待つことはできない。
主要な恩恵銘柄
-
NVIDIA: エッジAI向けGPU・プラットフォーム・エコシステムの中心 企業である。
-
Qualcomm, MediaTek: 低消費電力のエッジAIチップ需要の主要な恩恵銘柄
-
Samsung Electronics, SK hynix, Micron: エッジAIの普及に伴ってメモリ需要が拡大する代表的な恩恵銘柄だ。
-
LSCC, CEVA, SYNA: 低消費電力FPGA、設計IP、接続インターフェースの面で、エッジAIの恩恵銘柄と見ることができる。
8. パワー半導体の重要性
なぜ重要になったのか
AIサーバーでは、もはや計算性能よりも、電力をいかに安定して供給し、損失を減らし、発熱を抑えるかが重要になっている。NVIDIAも、従来の 54Vラック電力構成では今後のMW級AIラックを支えきれないとみて、2027年から 800V HVDCベースのデータセンター電力インフラへの転換を進めている。
重要なのは電力密度だ。AIデータセンターではGPUが増えるほど、電力損失、発熱、冷却負荷が同時に大きくなり、このとき電力を変換し制御するパワー半導体がボトルネックになる。そこで、Siベース部品よりも高電圧・高周波・高効率に強いGaN、SiCパワー半導体が中核部品として浮上した。
なぜSiCとGaNなのか
SiCは高電圧、高温、高熱の環境に強く、大電力変換に有利だ。
実際、SiCは高い降伏電圧、高い熱伝導率、高い動作周波数、高い動作温度という特性により、電力損失を抑え、熱管理とシステムの小型化に有利だと評価されている
GaNはより高いスイッチング周波数と高い電力密度に強い。AIデータセンター向けの800Vアーキテクチャでは、GaNはSiCよりも高い周波数をサポートし、高密度の電源供給構造に適しているという説明がある。
800V HVDCが生んだ変化
800V HVDCへの転換の意味は、単なる電圧上昇ではない。電力効率の改善、保守費用の削減、電力密度の拡大を同時に狙う構造変化だ。
エヌビディアとナビタスが提示した800V HVDC構造は、従来の54Vシステムに比べて、5%ポイントの電力効率改善、保守費用70%削減の効果を示した。
この構造変化により、パワー半導体は「補助部品」から「AIインフラの中核部品」へと位置づけが引き上げられた。
GaNパワー半導体市場は、年率 2023年 2億7,100万ドルから 2030年 43億7,600万ドルへと、平均 49%
バリューチェーン
パワー半導体のバリューチェーンを簡単に見ると、電力供給 → 電圧変換 → ラック配電 → サーバー内部の電源変換 という構造だ。ここでパワー半導体はUPS、PSU、DC-DCコンバータ、パワーモジュールの中に入り、AIサーバーが高電力化するほど重要性が高まる。
-
デバイス材料/チップ: GaN、SiCパワー半導体
-
パワーモジュール/変換: PSU、整流器、DC-DCコンバータpower+1
-
電力機器: HVDC電源装置、配電システム、ラック電力インフラ
-
最終需要先: AIデータセンター、AIサーバー、MW級ラック
AI時代に電力半導体が重要になった理由は単純だ。GPUをさらに多く搭載することよりも、その電力を効率よく変換し、耐えることのほうが重要になったからだ。
NVIDIAが2027年から800V HVDCベースのAIデータセンター電力構造へ移行すると明らかにしたことで、高電圧・高効率に強いGaN・SiC電力半導体が中核部品として浮上した。
最も直接的な恩恵を受けるのはNavitasだ。グローバルなバリューチェーンではInfineon・ST・TI・ROHM、韓国ではLS Electric・HD Hyundai Electric・Hyosung Heavy Industries・Sanil Electricのような電力インフラ企業が主要な恩恵銘柄と見なせる。
関連企業
-
TXN:NVIDIAの公式パートナー
-
ON: NVIDIA公式パートナー、SiCの垂直統合で唯一
-
NVTS: 純粋なGaNは唯一
-
STM: 欧州最大のSiC + GaN
-
MPWR: DC-DC/IC
-
COHU: テスト装置
-
AMKR / ASE: パッケージング
-
DB HiTek : 韓国最大の 8インチファウンドリ
-
KEC : SiC 1200Vの国産化
-
RFHIC : 韓国唯一のGaN大量生産
-
RF Materials : GaN RFパッケージ、エピウェハーの国産化
-
QRT : パワー半導体の信頼性評価専門、HBMテスト
-
ALT : 非メモリー後工程のトータルソリューション
9。サーバーのボトルネック — ブランドサーバー企業 vs ODM/EMS
AGENT AIの時代に入るにつれて、ボトルネックはサーバー全体のシステムへと移った。
AIがクラウドの外へ移動すると、データセンターを一つ使うだけではなく、複数の場所でそれぞれサーバーを個別に構築しなければならない。
一つのクラウドから数千、数万、数十万の場所へと設置先が分散するにつれ、サーバー全体の需要は飛躍的に増えた。
今はGPUを一つ確保することよりも、そのGPUをきちんと動かせるようにするメモリ、電力、冷却、基板、ネットワークがすべてかみ合ったサーバーを適時供給することのほうが難しくなった。(http://어려워졌다.biz)
とりわけAIサーバーは、従来の汎用サーバーよりもはるかに高い電力密度を持ち、電力供給の仕組みもより複雑だ。次世代GPUの消費電力が急増するにつれて、電力変換や制御部品の搭載量が構造的に増え、その結果、サーバーの組み立てと納品そのものがボトルネックになり始めた。市場では、基板、パワー半導体、冷却といった部品のボトルネックがサーバーの成長率まで押し下げる可能性があるとみられている。
ブランドサーバー企業は何をするのか
ブランドサーバー企業とは、簡単に言えば、サーバーを設計し、統合し、顧客に販売する会社だ。代表的な例としては、DELL、HPEのような企業がこれに当たる。
これらの企業は、GPU、CPU、メモリー、ストレージ、電源装置、冷却装置、ネットワークをひとつのシステムにまとめ、最終顧客に供給する。つまり、顧客が目にする「完成品サーバー」の顔がブランドサーバー企業だ。
ODM / EMS とは何か
ODMはOriginal Design Manufacturerの略で、メーカーが設計と生産をともに担うモデルを指す。顧客企業の要求に合わせて製品を開発・製造したあと、ブランド企業がその製品を販売する構造だ。
EMSはElectronics Manufacturing Servicesの略で、製造、調達、一部設計、テスト、物流まで含む電子機器製造サービスモデルを指す。簡単に言えば、単なる組立工場ではなく、ブランド企業の代わりにサプライチェーンと生産を運営する製造パートナーだ。
重要な違いはこうだ。ブランドサーバー企業は市場と顧客を押さえ、ODM/EMSは実際の製品を設計・生産・調達・物流で支える。
AIサーバー市場では、両者は競争相手というより共生構造だ。ブランドサーバー企業が顧客を獲得し、サーバー仕様を決めると、ODM/EMSがそれを実際の製品として素早く形にする。
例えばDELLやHPEのようなブランド企業は企業顧客やハイパースケーラーにAIサーバーを販売するが、その中に入るシャーシ、ボード、ラック、電源システム、一部のネットワーク機器は、Celestica、FlexのようなODM/EMSパートナーが設計・調達・生産する形だ。だからAIサーバーの受注が急増するほど、ブランド企業だけでなくODM/EMS企業も一緒に注目される。
なぜODM/EMSがより重要になったのか
AGENT AIの時代には、サーバーは単なる組立品ではなく、高密度電力・高速ネットワーク・液体冷却・高度な基板が同時に入る複合システムになった。このような構造では、ブランド企業だけで全ての製造を担うのは難しく、サプライチェーンを素早く回せるODM/EMSの価値が高まる。
特にCelesticaは、従来のEMSから高付加価値のODMモデルへ転換することが成長のポイントと評価されており、Flexもまた、製造を超えて調達・物流・電力ソリューションまで担う構造へ拡大している。
関連企業
- HPE, DELL, SMIC, PENG, CLS, FLEX
10. AI PC市場の拡大
AI PC市場が大きくなっている最大の理由は、AIが今や単に答えるだけのツールではなく、ユーザーのそばでそのまま実行するパーソナルエージェントへと変わりつつあるからだ。
AGENT AIは文書要約だけでなく、予定の整理、ファイル検索、会議の要約、アプリの起動、タスクの提案まで、即座に反応して継続的に支援する必要があるため、クラウドとの往復だけでは限界がある。
そこでAIはクラウドからPCの中へ入り始めた。オンデバイスで直接実行すれば遅延が減り、個人情報が外に出にくくなり、インターネットがなくても一部機能が動く。つまり、AI PCはAGENT AI時代の個人向け実行プラットフォームだ。
AI PCとは、簡単に言えばCPU、GPUに加えてNPUまで搭載し、AIを端末内で直接動かせるPCだ。核心は、生成AI機能の一部をクラウドに依存せずローカルで処理できる点にある。
こうした構造により、AI PCは会議要約、リアルタイム翻訳、文書整理、画像生成支援、パーソナライズ推薦のような機能をより速く自然にこなす。MicrosoftのCopilot+ PCが、この市場の代表的な基準点になった。
シェア
AI PCはもはやニッチではなく、主流へ移行する段階だ。ガートナー基準では、AI PCの比率は<strong>2024年 15.6%、 2025年 31.0%、 2026年 54.7%</strong>と予測され、2026年の出荷量は1億 4,311万台規模と示された。
市場では 2026年にAI PCがPC販売全体の半分を上回るという見方が共通して出ている。ASUSも 2026年にAI PCの販売が全体の 50%を上回り、 2027年には 60%以上に達する可能性があると見た。
NVIDIA・Microsoft・Armの新型AI PC
最も重要な変化は、NVIDIAがコンシューマーPC市場に本格参入したことだ。NVIDIAはMicrosoftとともに、個人向けAIエージェント時代のためのWindows PCを打ち出し、RTX Sparkという新しいスーパー・チップを公開した。
この流れの中核は、ArmベースのWindows AI PCだ。MicrosoftはCopilot+ PCを通じて、まずAI PCの基準を作り、その初期の軸はWindows on Armだった。ここにNVIDIAもArmベースのPCプロセッサーを発売する可能性が強く取り沙汰され、Microsoft + NVIDIA + Arm の組み合わせが新型AI PCの新たな軸として浮上した。
関連企業
- ARM , NVDA, MSFT, DELL, ARM, QCOM
11. ネオクラウドの重要性
ネオクラウドとは
NeoCloudは、簡単に言えばAI専用のGPUクラウドだ。http://모델이다.biz AWSやAzureのように汎用サービスを幅広く手がける構造というより、GPUコンピューティングとAIワークロードに集中して、より速く供給するモデルである。
これらはハイパースケーラーに取って代わるというより、不足しているGPU容量を埋める補完役に近い。だからAIブームが強いほど、NeoCloudの重要性は高まる。
なぜNeoCloudへ向かうのか
クラウドのシェアがハイパースケーラーからNeoCloudへ移っている。
クラウドからNeoCloudへ移る理由は、既存のクラウドがAIにきちんと追いつけなくなり始めたためだ。
重要なのはGPUの可用性、待ち時間、コスト、専門性 4を持つことだ。
1) GPUの可用性: 既存のクラウドはGPUが不足している
生成AIの急増でGPU需要は急拡大したが、既存のハイパースケーラーではGPUを確保するまでに2~4週間、ひどい場合は3か月以上**待たなければならなかった。
AI企業の約3分の1がGPU確保の遅れを経験しており、ある企業は90日待たされる。AGENT AIは推論呼び出しが多く、リアルタイム性が重要なため、この待ち時間はプロジェクト自体の遅延につながる水準だ。
2) 待ち時間: 既存のクラウドは遅すぎる
企業向けAIユーザーの約3分の1が、待ち時間の短縮がNeoCloudを選んだ最大の理由だと答えた。
既存のクラウドは、汎用ワークロード(Webサービス、データベース、ストリーミングなど)を処理するように設計されているため、AI計算専用に使うと非効率と遅延が発生する。一方、NeoCloudはGPU中心のアーキテクチャ、高速ネットワーク(NVLink、InfiniBand)など、AI計算に最適化されたインフラを提供する。
3) コスト: 従来のクラウドは高い
ネオクラウド利用の主な理由としてコストを挙げた割合は 13% だったが、そのうちほぼ半数が従来の大手クラウドからネオクラウドへ移行し、25% 以上のコスト削減を実現したと回答した。
従来のハイパースケーラーの GPU インスタンスは、汎用インフラの上に載った構造であり、AI 計算専用に使うと無駄なコストが漏れ続けると批判されることが多かった。実際、NVIDIA H100 DGX インスタンスを基準にすると、ネオクラウドの時間当たり料金はハイパースケーラーより約 66% 安いという分析も出た。
また、ネオクラウドはデータ送信やストレージに関する隠れコストが少なく、全体コストをはるかに予測しやすい。
4) 専門性: 従来のクラウドは汎用、ネオクラウドは AI 専用
ネオクラウドは、不要な要素をそぎ落とした構造だ。少数のことを非常にうまく行うよう設計されており、GPU 容量を迅速に提供し、AI ワークロードに最適化されている。
従来のクラウドが汎用ワークロードの処理を想定して設計されているのに対し、ネオクラウドはGPU中心のアーキテクチャ、AIソフトウェアスタックを標準搭載している。これは、高度化したGPUベースのAIワークロードにおいて、一般的なクラウドよりも競争力が高いことを意味する。
関連企業
CRWV
CoreWeaveは現在、ネオクラウドの代表的企業である。市場ではCoreWeaveを最大のネオクラウド事業者とみており、長期契約と大規模なバックログを背景に急成長していると評価している。http://평가한다.finance.yahoo)
強みはGPUクラウドプラットフォームそのものにある。単なるデータセンターの賃貸ではなく、AIワークロード向けのマネージドGPUサービスとソフトウェア層まで合わせて提供するフルスタック構造が核となる。
NBIS — Nebius
Nebiusは、ネオクラウドの中でも2026年末の年間売上ランレートを70億から90億ドルまで引き上げるという目標を示した
また、MicrosoftやMetaのような大手顧客との契約を通じて、ハイパースケーラーからの検証も得た。さらにNvidiaの投資も加わり、市場の注目度が高まった。
IREN
IRENはもともとビットコイン採掘インフラを基盤に出発したが、現在はAIクラウド・HPCインフラ企業へと転換中だ。重要なのは、電力と用地をすでに確保した状態で、AI向けGPUインフラへ迅速に切り替えている点だ。seekingalpha+1
特にMicrosoftとの5年契約が市場の注目を集めた。市場では、IRENは「電力ベースのインフラをAIクラウドに転換する代表的な事例」と見なされている。
APLD — Applied Digital
Applied Digitalは他のネオクラウドとは少し異なる。クラウドプラットフォームを直接運営するというより、液体冷却ベースのAIデータセンターキャンパスと賃貸インフラに強みがある。
つまり、APLDは「GPUをサービスとして売る会社」よりも、AI向けデータセンターを建設・賃貸するインフラ事業者に近い。AGENT AIが拡大するほど、GPUだけでなく電力・冷却・キャンパスそのものも不足するため、この種の事業の重要性も高まる。
12. AI基板のボトルネック
AGENT AIで基板がボトルネックとして浮上した背景には、AIがGPU性能を高めるだけでなく、「連続的な大規模推論」をリアルタイムで処理するようになり、基板の技術難度と供給圧力が同時に急上昇したためだ。
| 原因 | 説明 |
|---|---|
| 演算性能の向上 → 信号処理量の急増 | AI半導体の演算性能が高まるほど、より多くの信号をより速く処理する必要があるため、基板技術の難度が急激に上昇 |
| 微細工程競争 → パッケージング競争の拡大 | 半導体の微細工程競争がパッケージング競争へと広がり、既存のCoWoSボトルネックがFC-BGA、ABF、高多層MLB側へ移転 |
| リアルタイム大規模推論 → 基板・部品需要の非線形化 | AGENT AIは反復呼び出し、対話の継続、マルチステップ計画が多いため、GPU、MLCC、PCB、基板の需要は単純比例ではなく倍数で増加 |
| HBM基板と生産ラインの衝突 | HBM基板と小型PCB(mSAP)生産ラインが衝突し、納期が 6週→6月へと延び、供給網のボトルネックが全面的に拡散 |
| 供給業者の交換時に認証 6か月+ | 基板・部品の供給業者を交換する際、認証期間に 6か月以上必要で、ボトルネックが構造的に持続する可能性が高い |
| パッケージング・アンダーフィル・テスト・光通信・プローブカード増設の遅さ | 主要部品供給業者の増設速度がより遅く、ボトルネックが全面的に拡散し、ボトルネック区間が価格決定力の領域として浮上 |
| BroadcomがAIサプライチェーン制約を指摘 | BroadcomはTSMCの先端プロセス、レーザー、光トランシーバー用PCBを核心的制約として挙げ、光トランシーバーPCBのリードタイムが 6週→6月 |
AIサーバーはチップ性能が向上しただけでなく、パッケージサイズ、配線密度、電力消費、ネットワーク速度も同時に上昇し、その結果、基板と部品の仕様も急激に引き上がった。その結果、ボトルネックは順にCoWoSパッケージング → ABF/FC-BGA → MLB/CCL → MLCCへと移行する様子であり、特に高多層・大面積・低損失素材への対応が可能な企業に恩恵が集中する。
FC-BGA / ABF / ガラス基板
-
FC-BGA:高密度パッケージ基板、半導体チップを上下を逆にして(Flip-Chip)実装する高性能基板、GPU、CPU、AIチップを基板に接続し、高電力・高信号処理を担当
-
ABF基板:FC-BGAの核心絶縁材、FC-BGA基板で絶縁層を作るフィルム素材、FC-BGA基板の高多層構造を可能にする核心材料、ABFなしでは高性能FC-BGAの製作は不可能
-
ガラス基板:従来の有機基板(ABF)の反り・熱・精度の限界を解決
FC-BGAのボトルネックの核心的な背景は、AI GPUとASICが大型化するにつれて基板の層数と面積が同時に増加する一方で、ハイエンド製品の増産ペースが需要に追いつかないためである。未来アセット証券は、HopperからBlackwell、Rubin、Feynmanへと進むほどFC-BGAの必要量とABFの層数が引き続き増加し、2026以降はサーバー向けFC-BGAが供給者優位に転じる可能性が高いと分析した。
FC-BGA:AI GPU/ASICの大型化、層数増加、増産ペースの制約
ABF基板:CoWoS緩和後のボトルネック移転、高多層ABF需要の急増
関連企業
-
サムスン電機:FC-BGAとMLCCを同時に保有する代表的な恩恵銘柄
-
デドク電子:サーバー・半導体向けFC-BGA
-
LG Innotek: CPU向けFC-BGA参入によるASP改善が期待される
米国上場企業の中では、純粋なABF生産会社よりも、パッケージング・組立・高信頼性基板の方が現実的
-
AMKR: 先端パッケージング拡大の恩恵
-
SANM (Sanmina): AIサーバーインフラ向けバックプレーン・基板組立の恩恵
-
ガラス基板: SKC, Samsung Electro-Mechanics, Chemtronics / INTEL, GLW
PCB·MLB·CCL
-
PCB: 印刷回路基板、電子機器で複数の部品をつなぐ基本基板
-
MLB: 多層回路基板、PCB を複数層(通常 4層以上)に重ねた基板で、AIサーバーでは18層以上の高多層MLBが必須
-
CCL: 銅張積層板、PCBを作るための基礎材料で、信号損失と電圧安定性を左右する。AIサーバーではM8→M9系の低損失・高性能CCLが必要で、低CTEガラス繊維とHVLP銅箔の供給制約によりボトルネックが発生
PCBとMLBのボトルネックは、AIサーバー・スイッチ・ネットワーク機器の超高速化により、18層以上の高多層MLB需要が急速に増え、工程負荷と歩留まりの難易度も同時に上昇するために発生する。特に、Mirae Asset Securitiesは、**18層以上のMLBが2024~2029年に最も高い成長率を示すセグメントになるとみており、多層積層工法の拡大がASP上昇の鍵だと説明した
CCLのボトルネックは、PCBの上位材料におけるボトルネックである。AIサーバーと800G·1.6Tネットワークの拡大により、低誘電・低損失特性を持つハイエンドCCL(M8·M9系)需要が構造的に増加し、さらに低CTEガラス繊維やHVLP銅箔などの原材料供給制約も重なってボトルネックが生じた。つまり、PCBがより高速化するほど、単純な積層板ではなく「高性能CCLをさばけるサプライチェーン」が不足する構造になっている
関連企業
-
PCB基板: SYMC, TLB, Korea Circuit, TTMI
-
MLB基板: ISU Petasys, Daeduck Electronics
-
CCL: Doosan, Solus Advanced Materials, Lotte Energy Materials
**米国内で生産するPCB基板企業はTTMI (TTM Technologies) のみである
MLCC
- MLCC: セラミックを多層に重ねた超小型コンデンサ(電荷貯蔵部品)、電力の安定化 + 信号のフィルタリング + 電圧の急変動防止
MLCCのボトルネックは、AIサーバーの電力消費増加と直接連動している。GPUとASICの電力消費が大きくなるほど、高信頼性・超大容量MLCCの搭載量は非線形に増加し、先頭企業の稼働率が90~100%に近づいてもCapexは保守的に維持されるため、供給は急速に増えない構造だ。したがって、MLCCは単なる補助部品ではなく、電力安定化のボトルネックとして見るべきだ。
関連企業
-
Samsung Electro-Mechanics:PCB(FC-BGA) + MLCC 二重の好材料の大型株、NVIDIAの次世代ラックで PCB +233%, MLCC +182%が同時に急増
-
LG Innotek:PCB + MLCCを同時生産、二重の好材料
次世代パッケージング技術
- 微細プロセスの限界 → パッケージングによる性能拡張
-
半導体の微細プロセス(3nm, 2nm)が限界に近づくにつれ、パッケージングによって性能と電力効率を拡張する方法が重要な戦略として浮上
-
TSMC の CoWoS(Chip on Wafer on Substrate)などのパッケージング技術が、AI半導体の中核的な競争力として定着
- AIチップの大型化 → ウエハー当たりのチップ数減少
-
Hopper 30個 → Blackwell 16個 → Rubin 6個へと、12インチウエハー 1当たりの純チップ数が急減
-
大面積チップを効率的にパッケージングするために、CoWoS、FO-PLP(Fan-Out Panel Level Packaging)のような次世代技術が不可欠
- HBM連携 → パッケージングの複雑さが増加
-
高帯域幅メモリ(HBM)をAIチップと一つのパッケージに統合する必要があるため、パッケージング工程がサプライチェーンのボトルネックとして作用
-
TSMCのCoWoS CAPAが需要に追いつけず 2024~2025 までパッケージングのボトルネックが深刻化
- マルチチップ統合 → インターポーザ・リデューサーが必要
-
GPU、CPU、メモリ、ネットワークチップを一つのパッケージ構造にまとめる必要があるため、シリコンインターポーザ、リデューサー、アンダーフィルなどの部材と工程が必須
-
従来のFC-BGAとシリコンインターポーザが同時に限界を示す中、ガラス基板(Glass Substrate)のような次世代の代替案が登場
- パッケージングのボトルネック → 基板のボトルネックへの移行
-
2026TSMCによるCoWoS CAPAの積極的な増強により、パッケージングのボトルネックは緩和
-
ただし、ボトルネックはABF・FC-BGA・高多層MLB・高性能CCL・MLCCへと移行
AI半導体競争の核心は、もはやチップそのものではなく、パッケージングと基板にある。
-
CoWoSのボトルネック緩和 → FC-BGA・ABF・高多層MLB・高性能CML・MLCCのボトルネックが出現
-
次世代パッケージング技術(CoWoS、FO-PLP、ガラス基板)は、大型チップ・HBM連携の鍵
3DIC最近のニュース:AI半導体の新たなボトleneck、先端パッケージング(2026)
3DICとは、チップを上下に積み重ねて一つのパッケージにまとめる技術だ。チップ間の距離が短いためデータのやり取りが速くなり、電力消費も減る。TSMCのCoWoS、SoIC、IntelのFoveros、SamsungのI-Cubeが各社の実装方式だ。HBMもDRAMダイを積み重ねる 3DIC方式だ。
市場規模は急拡大している。Mordor Intelligenceは 2.5D·3DIC市場が 2025から 112億 4,000万ドルに拡大し、 2026までに 148億 4,000万ドルに達すると見込んだ。さらに、2031年まで年平均 32%成長し、 451億 9,000万ドルに達するとした。需要はあるが供給が追いついていない。NvidiaがCoWoS容量の 60%を使うとの分析が出ており、CoWoSラインはボトルネックになった。
TSMCは 2026年末までにCoWoS生産を月間 15ウェーハ枚に引き上げると表明し、設備投資 520億〜560億ドルのかなりの部分をパッケージングに投じる。問題は技術的な限界だ。12層HBM3Eの歩留まりは 50%前半にとどまり、8層で 70〜80%の歩留まりが 12層になると 50%を下回り、パッケージ当たりコストはほぼ倍増する。パッケージ電力はBlackwell・Rubin級チップで 1,400〜2,000ワットを超え、既存の冷却では対応しにくい。
設計自動化もまだ未完成の領域だ。Cadenceは 2026年 4月にMillenniumとAllegro X AIを発表したが、最終検証(signoff)は依然として顧客の苦痛だと述べた。エコシステム拡張の動きは明確だ。imec傘下のIC-LinkがTSMCの 3DFabric Allianceに加わり、IntelはEMIB-Tロードマップを公開した。Samsungは、ファウンドリ・メモリ・パッケージングを束ねるターンキー戦略でTSMCのボトルネックを回避しようとする設計を進めている。
投資家の観点で重要なのは単純だ。CoWoSのボトルネック解消の速さがGPU出荷量とHBM需要の先行指標になる。 3DIC歩留まりが上がってこそ高コスト構造が解消され、AIサーバー供給の速度が速まる。SamsungのHBM4とパッケージングのターンキー受注獲得の有無が 2026〜2027年の国内半導体株の主要変数だ。
関連企業
-
ASE: 世界最大の先端パッケージング専門企業であり、 TSMCのCoWoSと競合するCoWoS代替技術を保有
-
AMKR: 先端パッケージング拡大の恩恵、 北米拠点の高信頼パッケージング・組立の恩恵
まとめ
このように、AGENT AI への転換点において、数多くのボトルネックが発生していることが分かる。
今や企業はAIで利益を上げ、企業内ではAGENT AIが人間に取って代わる。
Googleの増資やMetaの投資など、ビッグテックはCAPEX投資を思い切って拡大しており、この投資は止められない。
ここでは、鉱山企業よりもツルハシ企業をうまく見つけて、主導株としてうまく引っ張っていければよいと思う。
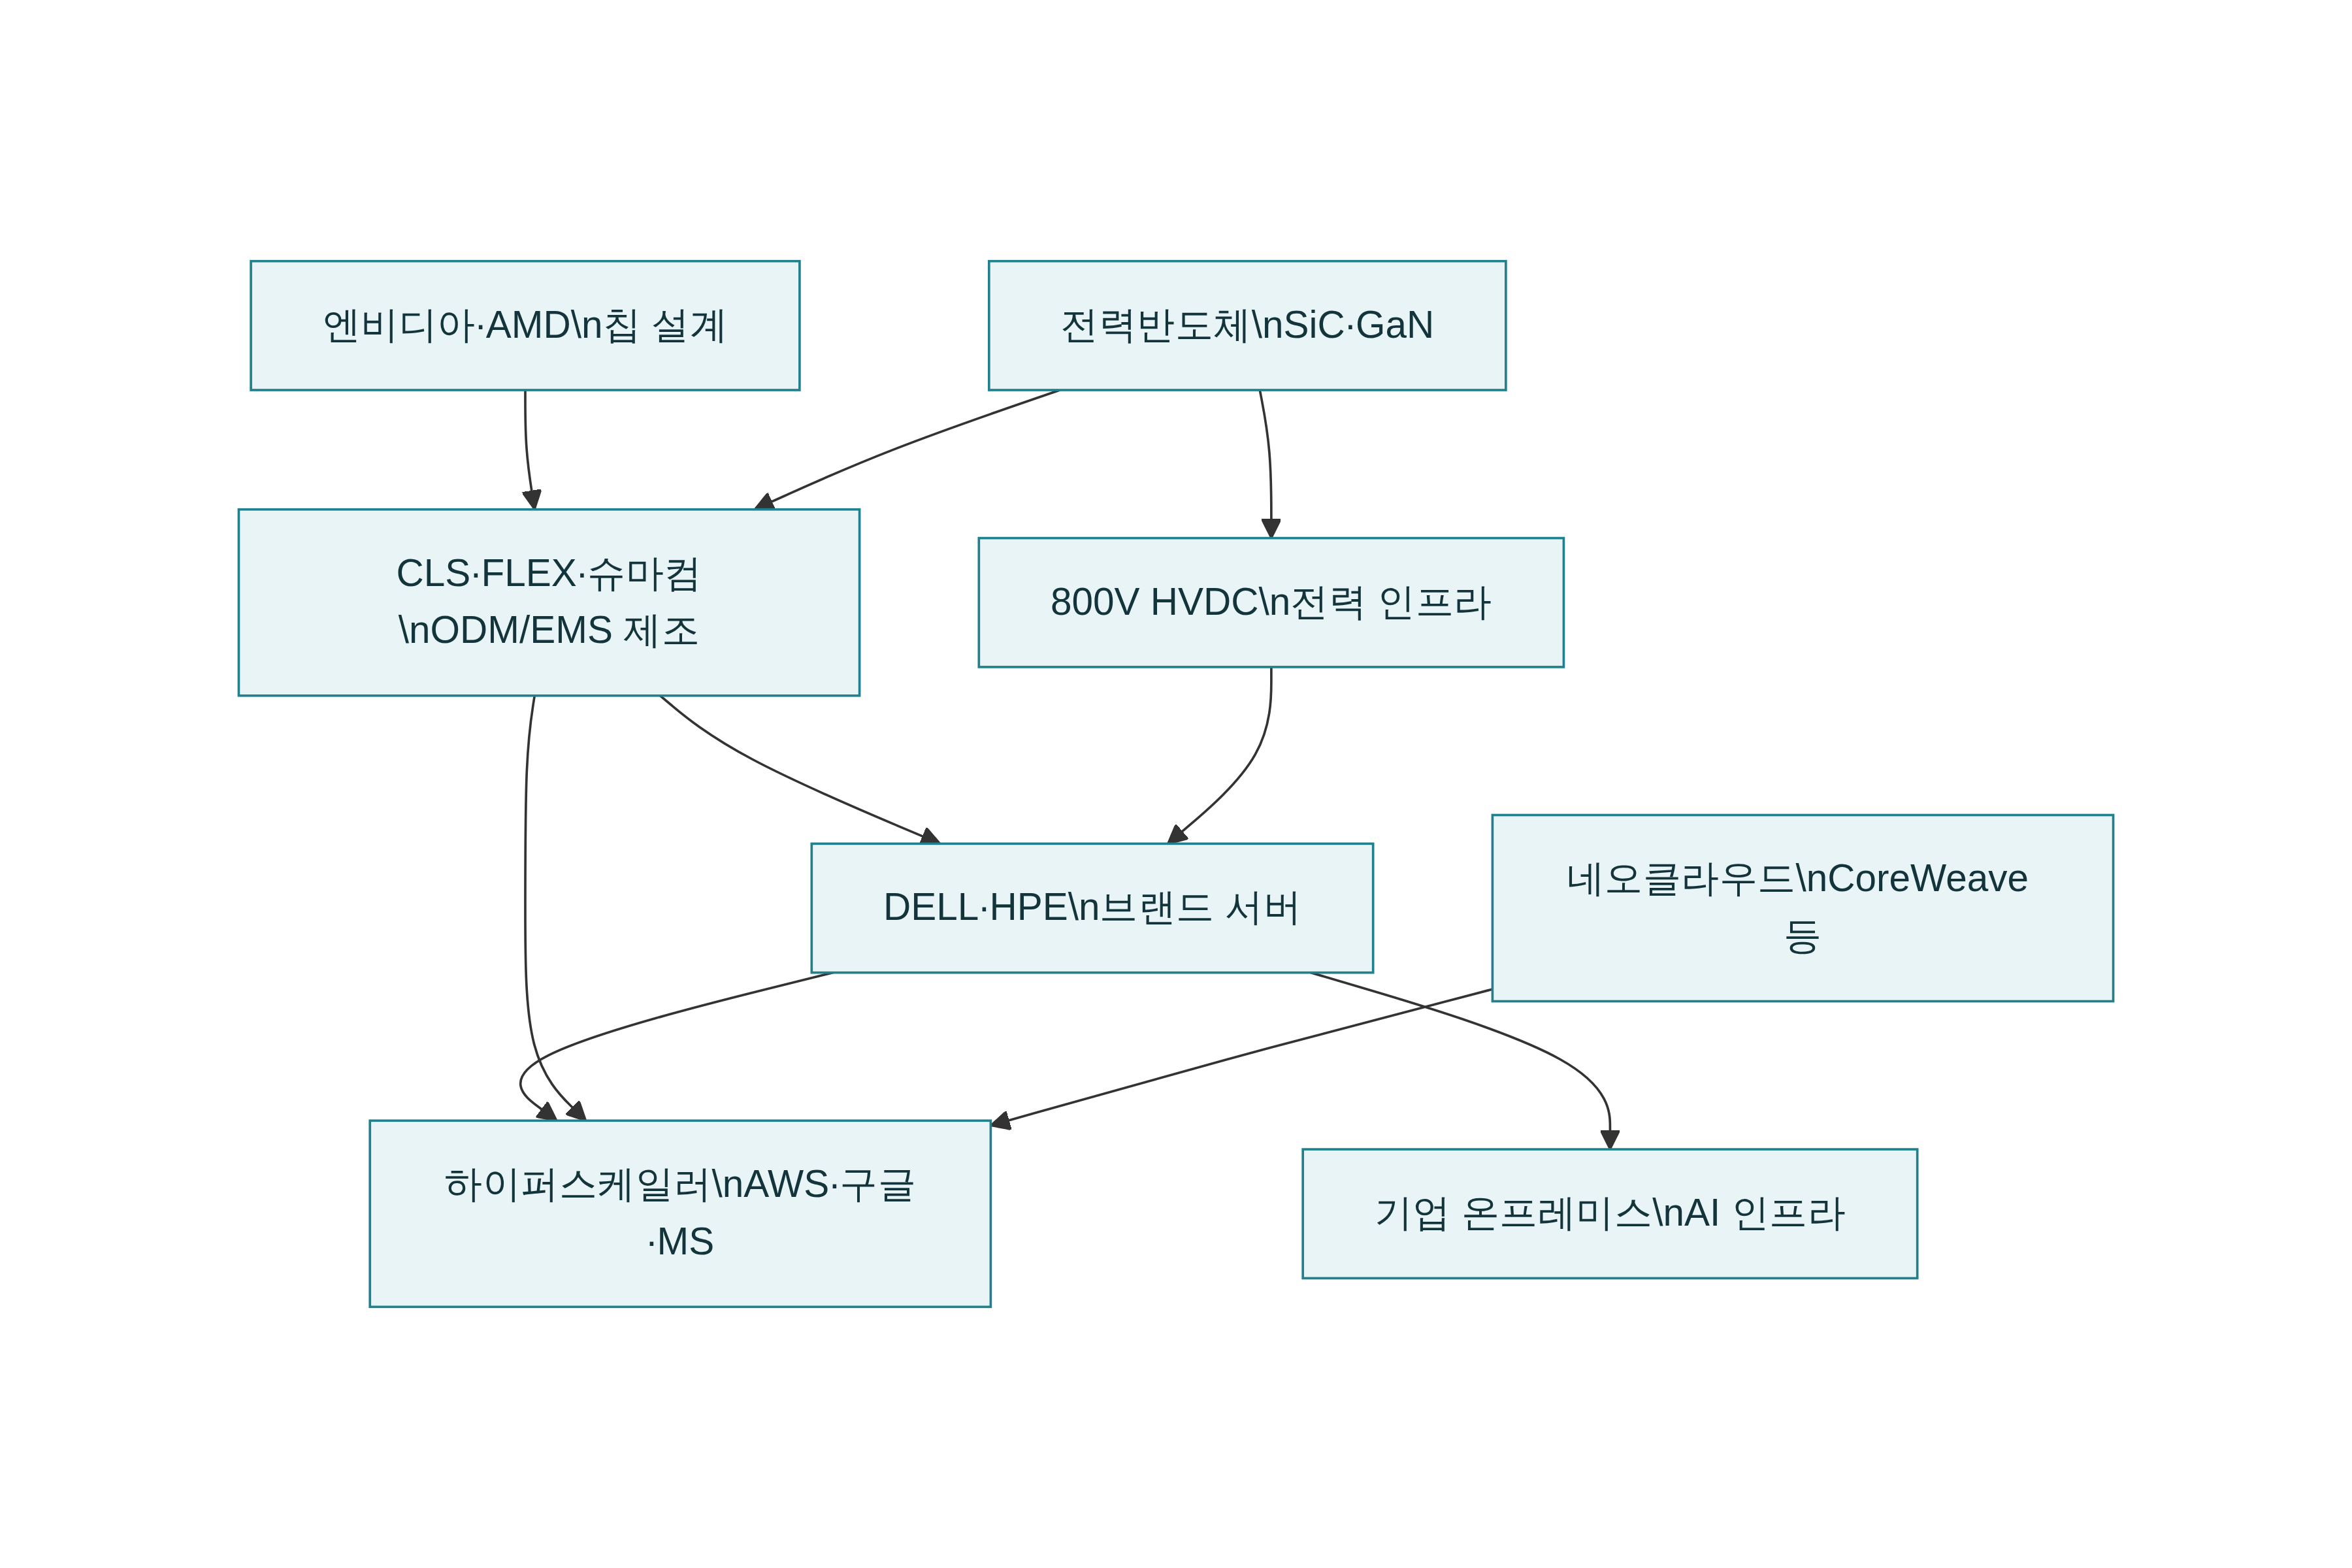
現在の主導株である光通信、メモリ半導体を主力として引き続き引っ張っていきつつ、次のボトルネックとなる企業に資金が集まり、/技術的にブレイクアウトすれば、比重をさらに増やしてみてもよいのではないかと思う。
よくある質問
AIエージェントの転換点で、GPU供給不足は企業利益にどのようなボトルネックを生むのでしょうか?
GPU供給不足は演算容量を制限し、コストを押し上げ、製品導入と売上拡大を鈍化させます。
KVキャッシュはAIエージェントでなぜボトルネックになるのか?
KVキャッシュは数百万トークンをリアルタイムで処理し、メモリ容量を超えてGPUを待機させる。
リアルタイム推論の遅延はAIエージェント製品の採用にどのような影響を与え、どう減らせるのか?
リアルタイム推論の遅延は製品採用を遅らせ、売上機会を減らす。大容量・低コストのメモリ(HBF・NAND)、ネットワーク(光通信・CPO)、キャッシュ最適化で緩和する。
HBFとは何か、そしてメモリ市場にどのような意味があるのか?
HBFはNANDベースの高帯域幅フラッシュで、HBMの容量制約を8~16倍補完する。商用化されれば、大容量キャッシュ需要による収益性改善要因となる。
NANDとHDDのうち、AIインフラではどちらがより重要ですか?
用途によって異なる。NANDは大容量・低コストのKVキャッシュに、HDDは学習・推論データの長期保管に重要だ。