Bullstory Research 2026年6月17日
CPU? GPU? これからはNPUの時代だ!
要点
2026年 月時点で、オンデバイスAIの主役はNPUです。NPUは 6W級の超低消費電力でリアルタイム推論を可能にし、スマートフォン・自動運転・家電にすぐに適用できます。Samsung Electronicsは、ファウンドリーのサプライチェーンで最大の恩恵を受ける銘柄と見なされています。1種類
ポストNVIDIA時代を支配するオンデバイスAIバリューチェーン徹底レポート
いつまでNVIDIAのGPUとHBMサプライチェーンだけを見続けるつもりですか。
半導体コンピューターの歴史を始めたCPU、人工知能の華々しい幕開けを告げたGPU…
次の王座は、間違いなくNPU(ニューラル・プロセッシング・ユニット)です。
この流れを知らなければ、半導体のメガトレンドにおいて 2026年以降、完全に取り残されるほかありません。
世界の株式市場を熱く盛り上げてきた人工知能(AI)インフラ投資サイクルが、大きな質的転換期を迎えています。ここ数年間、ビッグテック企業が天文学的な資金を投じてきた「ビッグテックのデータセンター向けインフラ(GPU・HBM)」の構築ペースは、徐々に安定期に入りつつあります。
いま、汝矣島とウォール街のスマートマネーは、インフラ構築の次の段階、すなわち巨大な人工知能サーバーなしに、手の中のスマートフォン、オンデバイス家電、ロボット、自動運転車が自ら考え判断する「オンデバイスAI(On-Device AI)」と「エッジAI(Edge AI)」市場へと急速に移行しています。
この巨大なパラダイムシフトの中核となる脳細胞であり、人工知能演算の絶対的な主導権を握るハードウェアこそ、NPU(Neural Processing Unit、ニューラル・プロセッシング・ユニット)で785す。半導体産業の設計と流通の権力地図を丸ごと変えているNPUエコシステムの本質を分析し、受注モメンタムが本格的に数字で証明され始めた国内の主要バリューチェーン受益銘柄を、(2026年 6月)時点で余すところなく解剖します。
1. クラウドAIの見えない壁:オンデバイスAIが必然である理由
これまで世界を驚嘆させてきた大規模言語モデル(LLM)ベースのAIは、完全な5520「中央集権型クラウド」206構造でした。スマートフォンやPCからAIに質問を投げると、そのデータは基地局を経由し、海底光ファイバーケーブルを通って超巨大ハイパースケールデータセンターへ送信されます。そこに高密度に配置された数万台のNVIDIA GPUサーバーが膨大な電力を消費して演算を行い、その後、結果を再び私たちのデバイスへ送り返す仕組みです。
しかし、人工知能が日常生活にある数百億個のデバイスへ入り込まなければならない現在、このようなクラウド方式は、持続不可能な三つの致命的な限界に直面しています。
-
物理的な遅延時間(Latency)の限界:
完全な自動運転を目指す車両が前方の突発的な障害物を発見したとき、クラウドサーバーと信号をやり取りする間に 0.2~0.3秒のデータバッファリングが発生すれば、これは直ちに大惨事につながります。ロボット制御や遠隔医療手術もまた、リアルタイムの応答性が生命線です。 -
プライバシーと企業セキュリティの崩壊:
個人の機密性の高い生体データや金融情報だけでなく、企業の中核機密であるソースコードまで、AI計算のたびに外部サーバーへ流出するという点は、世界の規制当局と企業が最も懸念している部分です。外部からのハッキングの脅威に対して、安全な「クローズド型オンデバイス処理」が強制される理由です。 -
サーバー稼働コストの幾何級数的な増大と世界的な電力不足:
世界中の人々が毎日何十回もクラウドAIを利用するようになると、大手テクノロジー企業が負担すべきデータセンターの電力コストとサーバー維持費は、企業の存続を脅かす水準まで急増します。最終的には、計算負荷を個々の消費者の端末(エッジ側)へ分散して初めて、AIエコシステムを維持できます。
この三つの根深い問題を根本的に解決する唯一の鍵が、外部インターネットネットワークへの接続なしに、AI推論をすべてデバイス自体の内部で完了させる「オンデバイスAI」774であり、これを実現するために生まれた専用半導体こそがNPUです。
2. 半導体三国志:CPU vs GPU vs NPUの構造的な違いを比較
なぜ既存のCPUやGPUではオンデバイスAIを完全に実現できないのでしょうか。
半導体のアーキテクチャ構造を見れば、その答えは明確になります。
| 区分 | CPU(中央処理装置) | GPU(画像処理装置) | NPU(ニューラル処理装置) |
|---|---|---|---|
| 中核構造 | 少数の強力なコア(Sequential) | 数千個の汎用コア(Parallel) | AI行列演算に最適化されたコア(MAC中心) |
| 演算方式 | 直列処理(複雑な命令制御) | 並列処理(グラフィックピクセルのレンダリング) | 高速な行列およびベクトル演算(AI推論) |
| 消費電力 | 通常 | 非常に高い(電力食い) | 非常に低い(超低消費電力・高効率) |
| フォームファクターの制約 | 低い | 非常に高い(大型クーラーが必須) | 非常に低い(小型機器への搭載が容易) |
| AI効率 | 低い | 高い(学習・大規模推論に適する) | 最大化(デバイス内のリアルタイム推論に最適化) |
CPU:シリアル処理の代償、複雑な命令制御
コンピューターの頭脳であるCPUは、非常に複雑で多様な命令を順番に処理することに特化しています。数人の賢い天才が順番に問題を解くような構造であるため、何億もの単純な行列データが一度に押し寄せる人工知能のディープラーニング演算を処理するには、構造的に速度が遅すぎます。
GPU:並列演算の強者、汎用AIの始まり
NVIDIAを世界最高の企業にしたGPUは、もともと数千個のコアを活用してモニター画面の3Dグラフィックスピクセルを同時に描画するために作られた半導体です。膨大なデータを同時に処理する**「並列演算」能力に優れており、AI学習(トレーニング)や大規模演算で卓越した性能を発揮します。 **하しかし、生まれながらにグラフィックス用の汎用チップであるため、AIには不要な演算装置が含まれており、電力を途方もなく消費します。また、チップのサイズが大きいため、バッテリーで駆動するモバイル機器には搭載できません。
NPU:人工知能だけのために生まれたスペシャリスト
NPUは、人間の脳のニューロンとシナプスの構造を模倣したCNN、RNN、Transformerなどの人工ニューラルネットワークアルゴリズムを用い、わずか1W(ワット)の電力でも超高速処理を行うために設計された専用半導体です。グラフィックス処理や不要な汎用制御回路を大胆に省き、AI推論の中核である行列乗算および累算(MAC)回路だけを集約しています。
その結果、同じAI推論タスクを実行する場合、消費電力をGPUの10分の一の水準まで削減しながら、演算速度は圧倒的に高めるという、驚異的な効率性を実現しました。電力制限と発熱制御が製品の生命線であるスマートフォン、ウェアラブル、スマート家電、車載半導体市場で、NPUが王座を占めざるを得ないハードウェア上の理由です。1:
3。既製服からオーダーメイドへ:半導体設計の権力の大移動とDSPの台頭
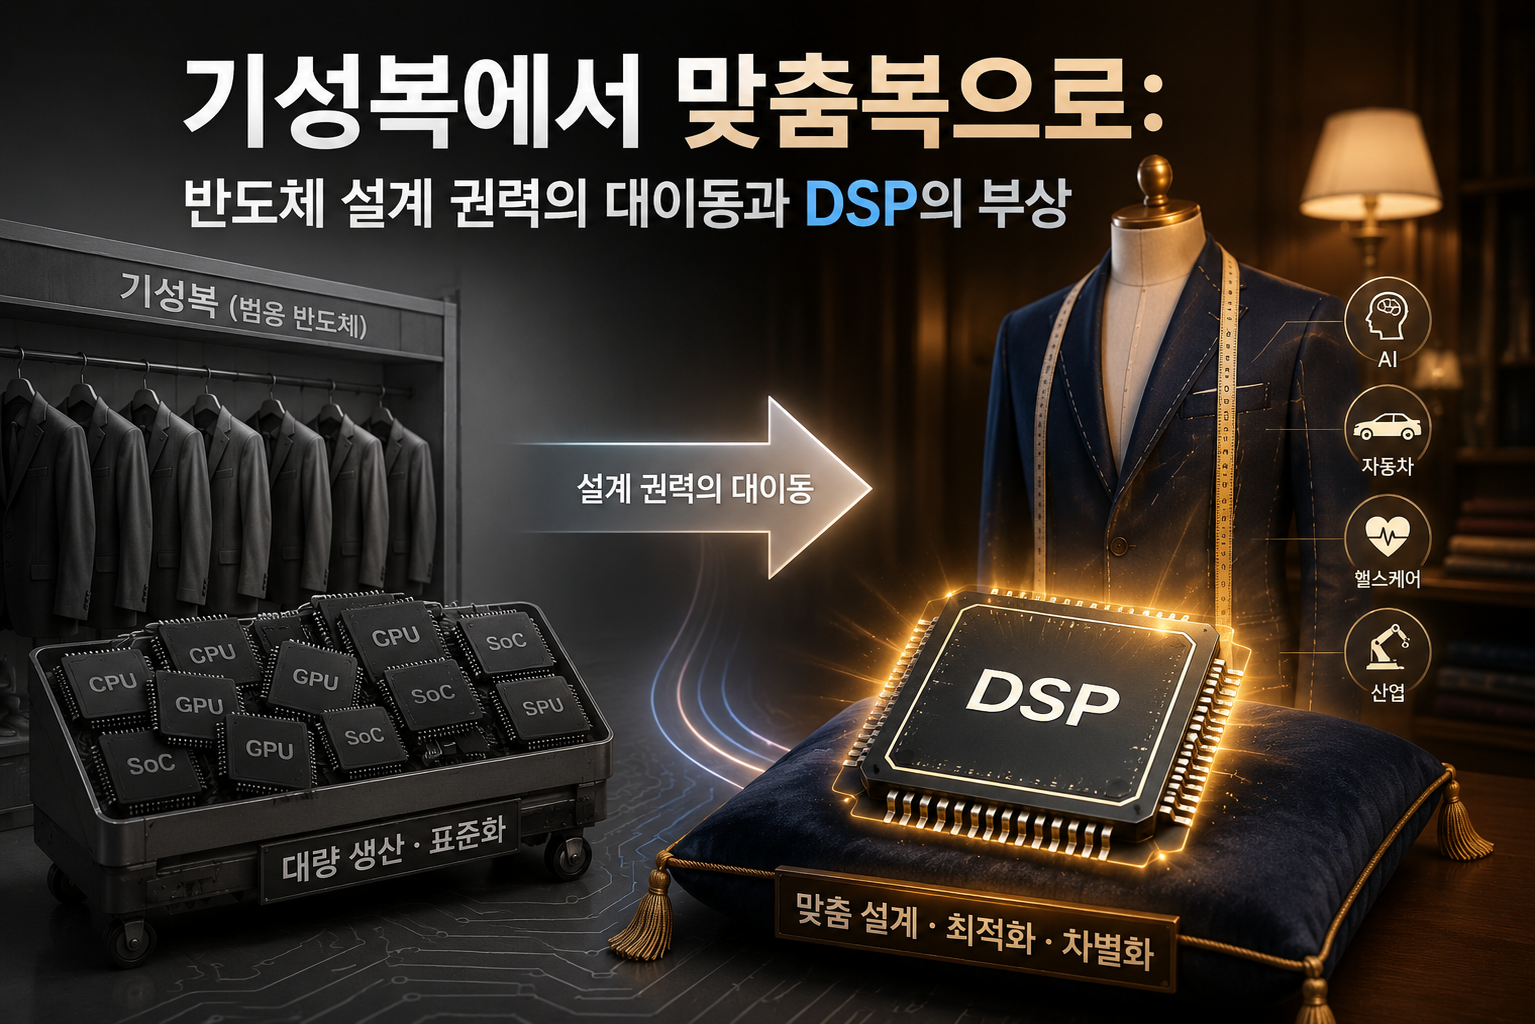
クラウドAI市場では、Nvidiaが既製服のように量産する汎用GPU(H100、B200など)を大量に購入してデータセンターに設置すれば十分でした。これを「少品種大量生産」の時代と呼びます。
しかし、オンデバイスAI時代は、完全な「多品種少量のオーダーメイド生産(ASIC)」の時代です。スマートフォンに搭載されるAIチップ、ロボット掃除機に搭載されるAIチップ、スマート冷蔵庫に搭載されるAIチップ、そして自動運転車に搭載されるAIチップは、必要な演算能力(TOPS)、許容電力、センサーインターフェースがすべて異なっていなければなりません。
これに伴い、世界のビッグテック企業(Apple、Google、Tesla、Metaなど)や家電・自動車メーカーは、NVIDIAやQualcommが提供する汎用チップをそのまま使用せず、自社製品の仕様に 100% 最適化された「自社カスタムNPUチップ(特定用途向け半導体・ASIC)の設計」に直接乗り出し始めました。
ここで非常に大きな構造的投資機会が生まれます。世界中の数多くの企業が独自のNPUを作りたいと考えていますが、半導体の物理回路図を微細なファウンドリ工程(3nm、 4nmなど)に合わせて実装することは、まったく別次元の領域です。莫大な費用のかかる微細工程資産と、熟練したエンジニアリングインフラが必要だからです。
最終的に、半導体の中核となる基礎回路図を提供する「IP(設計資産)企業」と、ファブレス企業の抽象的な設計図をSamsung ElectronicsやTSMCなどのファウンドリ工場の仕様に合わせ、最終的な物理チップへ変換する「デザインハウス(DSP)」企業が、世界のカスタムNPU受注を独占する新たな波及効果のエコシステムが開かれました。
4。ポストNVIDIA時代、口座に必ず組み入れるべき国内NPU主要受益株 TOP 4
世界のオンデバイスAI市場が爆発的に成長する中、特にSamsung Electronics Foundryの先端微細工程エコシステムの最前線に立ち、世界のビッグテック企業からの独占的なカスタムNPU受注を取り込んでいる国内主要銘柄に注目すべきです。これらは単なるテーマ株ではなく、世界の受注契約を背景に業績が上向いているファンダメンタル主導銘柄です。
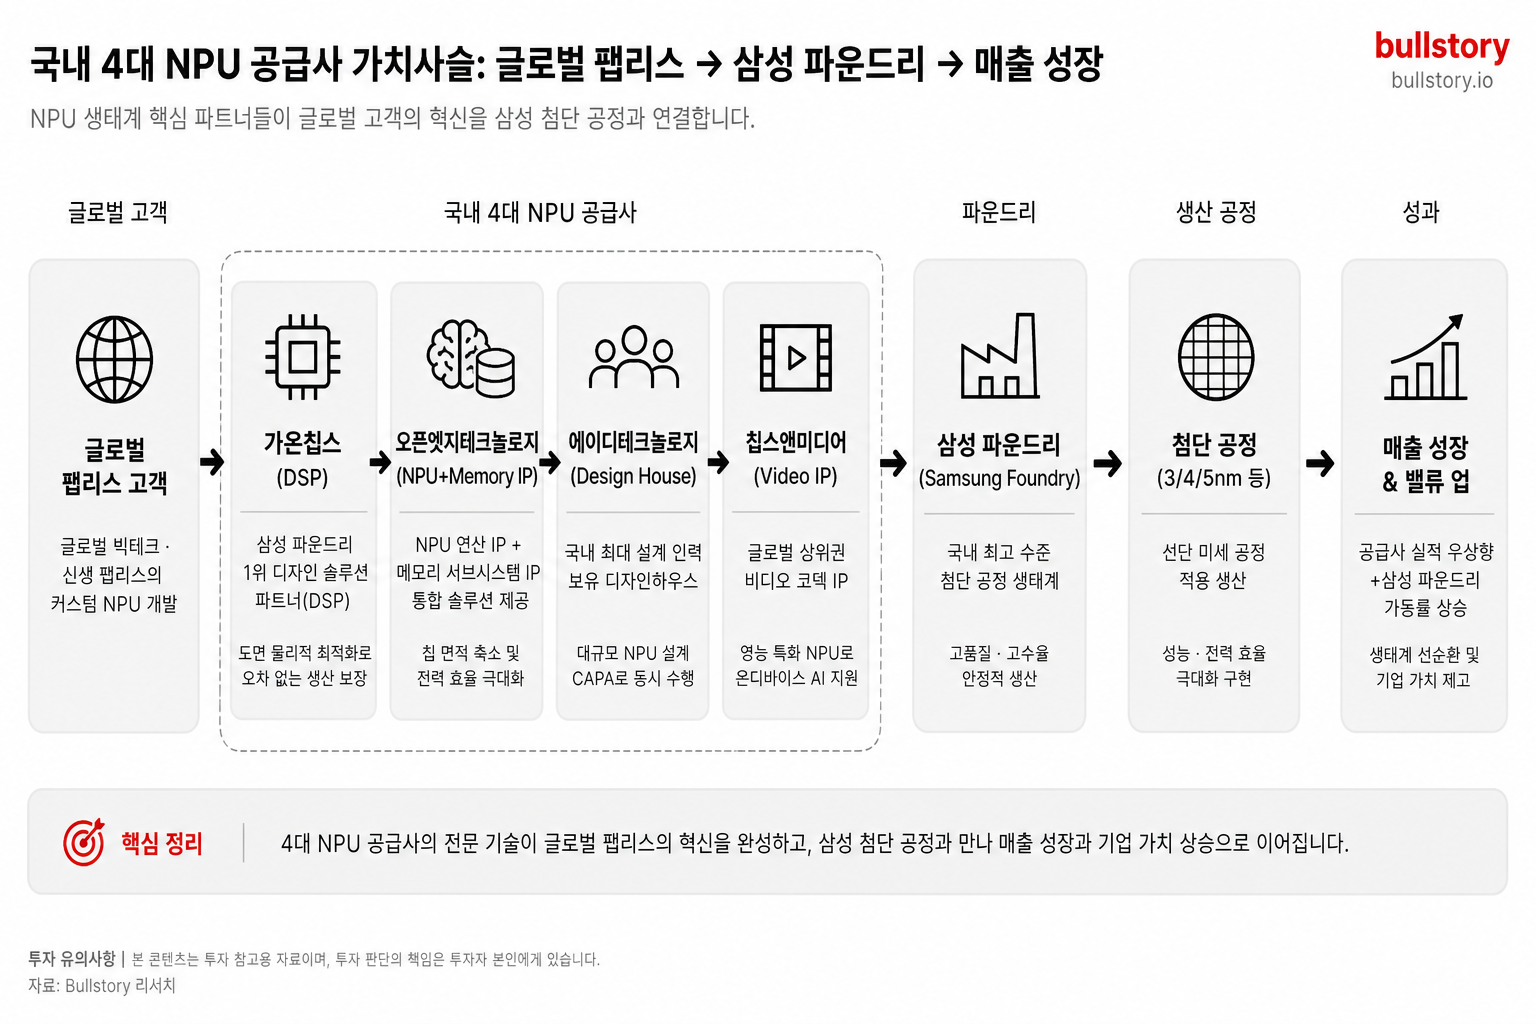
四つの韓国NPUサプライヤー(DSP、IP、デザインハウス、ビデオIP)が、グローバルなファブレス顧客とSamsungの先端 fをどのようにつなぐかを示すバリューチェーンを図示する
①Gaonchips (399720): グローバルな先端NPU受注の架け橋、名実ともにDSPの筆頭銘柄
Gaonchipsは、グローバルなファブレス企業やセットメーカーが設計した半導体図面を、Samsung Electronicsの最先端ファウンドリ工程(3ナノメートル、4ナノメートル、5ナノメートルなど)で実際に誤差なく生産できるよう、最終的な物理最適化を行う、Samsung Foundryエコシステム内で圧倒的な 1位のデザインソリューションパートナー(DSP)です。
-
比類のない高付加価値ポートフォリオ:
Gaonchipsは単なる低価格のレガシーチップ企業ではなく、技術的参入障壁が最も高い「車載用AI半導体」と「ハイエンドのオンデバイスNPUチップ」プロジェクトの受注比率が、総売上高のかなりの部分を占めています。微細工程チップ設計の経験は韓国で最も豊富です。 -
グローバルな領域拡大のモメンタム:
最近、半導体復活を狙う日本市場に支社を設立することに成功し、現地のグローバル大手顧客から大規模なカスタムNPU開発プロジェクトを相次いで受注しています。Samsung Foundryの先端工程の稼働率上昇と歩調を合わせ、最も確実で爆発的な業績回復を示すセクター内の筆頭銘柄です。
②Openedges Technology (394280): NPUの頭脳と血管を同時に切り開く世界唯一のIP企業
半導体を直接製造せず、チップ設計の中核となる設計資産(IP)を販売し、それに伴うライセンス料およびロイヤルティを受け取る、高マージンの半導体IP専業企業です。
- 統合AIプラットフォームの独占的な堀:
OpenEdgeの最も強力な技術的障壁は、「NPU演算IP」と「メモリサブシステム(PHY、コントローラー)IP」を一体型の統合ソリューションとして提供できる世界で唯一の企業である点です。
NPUの頭脳演算がどれほど速くても、データを運ぶメモリの高速道路がふさがれば、チップ全体が機能停止します(ボトルネック)。OpenEdgeは、データが行き交う超高速で有機的な接続経路を一度に最適化し、チップ面積を縮小して消費電力を最大化するため、オンデバイスAIチップを独自開発しようとする世界の新興ファブレス企業にとって不可欠な関門として確立しました。\20;**85C;ロイヤルティ中心の高収益構造が定着する段階です。
③ (200710): 圧倒的なエンジニア規模を誇る大規模DSPレバレッジ
過去のTSMCエコシステムの中核パートナーから、Samsung Electronics Foundryの公式DSPへと転じた、独特で重厚な経歴を持つデザインハウス企業です。
- 設計CAPAの規模の優位性:
デザインハウス事業の中核となる生産能力は、ほかでもない熟練した半導体設計エンジニアの人数785ADTechnologyは韓国最大規模の設計人材インフラを保有しています。世界の巨大テック企業が数兆ウォン規模のカスタムNPUチップの多品種少量生産を委託する際、大型プロジェクトを遅延なく同時並行で完遂できる、韓国でも数少ない企業です。グローバルARMエコシステムとの強固なパートナーシップを基盤に、大規模な波及効果が生じた際には、株価の弾力性がGaonchipsに劣らないほど強く跳ね上がる可能性のある中核的な主導銘柄です。2。
④ Chips&Media(094360):『映像(ビデオ)データ』を扱うすべてのエッジAIにおける独占的パートナー
スマートフォン、自動車、ドローンなどが物体を認識するために不可欠な「ビデオコーデック半導体IP」分野で、世界市場シェア上位を確固として維持してきた独自性の高い企業です。
- 映像特化型NPUへの事業転換:
最近のオンデバイスAI市場の幕開けに合わせ、リアルタイムの高精細映像データ分析に完全特化した自社の**「映像専用NPU IP(NPU-VA)」の開発を成功裏に完了し、商用化による売上を上げ始めました。オンデバイスAIが最も破壊的に搭載される領域は、リアルタイムの高精細カメラ映像を分析して自動運転を行い、危険を検知する必要があるスマートカー(ADAS)、ロボット工学、AI監視カメラなどです。すでに確保している世界中の数百社に及ぶ車載・IT半導体顧客ネットワークに新型NPU IPを組み込んで販売するクロスセル戦略が加速し、売上増加がそのまま純利益に直結するレバレッジ局面に入りました**。
5. 2026年下半期のNPUセクター投資戦略および主要リスクの点検
NPUバリューチェーンは、単なる期待感だけで動くテーマ株ではなく、グローバルサプライチェーンの中心軸が移動することで生じる「構造的な大勢上昇サイクル」785したがって、短期的な株価の上下に一喜一憂するよりも、中長期的な視点での分割買いアプローチが非常に有効です。
実践投資バイブル
-
中長期ポートフォリオの分散:
セクターの主力銘柄として最も安定した業績の見通しを示すGaonchipsをポートフォリオの堅固な中核(ベータ・プレイ)とし、技術ロイヤルティの拡大余地が無限大のOPENEDGES Technologyや、映像特化のモメンタムが強力なChips&Mediaを組み合わせ、アルファ収益率を最大化する戦略が合理的です。 -
徹底した分割買いのタイミング運用:
どれほど優れた主導セクターであっても、世界的なマクロ経済要因やファウンドリーの需給問題によって一時的な価格調整を経験するものです。企業固有の堀が損なわれていないなら、市場全体の需給不安定により株価が移動平均線や主要な支持線まで美しい押し目調整を見せるたびに、保有比率を積極的に引き上げる戦略が有効です。60日
必ず確認すべきリスク要因
-
先端ファウンドリーの歩留まりおよび工程遅延リスク:
デザインハウスやIP企業の業績は、最終的にファウンドリー工場でチップが無事に量産されて初めて最大化されます。Samsung Electronicsなど主要ファウンドリーの最先端微細工程における歩留まり確保が遅れたり、ビッグテックのチップ量産スケジュールが延期されたりした場合、関連企業のロイヤルティおよび売上認識の時期が後ろ倒しになる可能性があるため、四半期ごとの量産開示を綿密に追跡する必要があります。 -
世界のビッグテックが自社の技術仕様を内製化するスピード:
A80;20;ハイパースケール企業が20;D514;デザインハウスや外部IPを一切介さず、完全な自社内エコシステムの構築に成功した場合、受注のパイが一部縮小する可能性があります。しかし、多品種少量生産の特性上、中小ファブレス企業の数が爆発的に増えているため、市場全体のパイの拡大がこれを十分に上回って相殺する構造となっています。
6。結論:主導銘柄のパラダイム変化を先取りせよ
歴史的に、株式市場で最も莫大な利益をもたらしてきた銘柄は、常に「新たなハードウェアの標準」が制定され、市場に普及する初期段階で生まれてきました。スマートフォン導入初期の部品銘柄がそうであり、電気自動車の普及率が上昇した時期の電池材料銘柄がそうでした。
過ぎ去ったデータセンター中心のGPU、HBMラリーを追いかけて高値づかみし、後追いの投資に埋没している場合ではありません。人工知能がデータセンターの重い鉄の扉を開けて外に出て、私たちの日常にあるあらゆる物の頭脳となるオンデバイスAIの時代、そしてその心臓の役割を担うNPUバリューチェーンは、いままさに巨大な数年にわたるピークサイクルの初期段階を通過し始めています。
ハードウェア製造の領域を超え、グローバルなビッグテック各社のカスタムメイドの頭脳を直接設計し、図面を描く**「知識と技術の領域」に賭けてください。 **그**それがポストNvidia時代を貫く、最も確実で賢明な投資の道標となるでしょう。
よくある質問
CPU、GPU、NPUの違いとは?
要点:CPUは複雑な命令を順番に処理し、GPUは数千の並列コアで大規模な演算を処理します。NPUは行列演算(MAC)だけを最適化し、低消費電力でリアルタイム推論を処理します。
NPUとGPUの違いは何ですか?
要点:GPUは汎用並列演算に強い一方、消費電力と発熱が大きくなります。NPUはMAC回路を集約し、同じ推論における電力を 10の 1水準まで低減します。
NPUはどのような構造になっていますか?
要点:NPUは乗算・累算回路(MAC)を大量に集積し、行列乗算を高速に実行します。汎用制御を取り除くことで、 1ワット級の低消費電力設計が可能です。
NPU関連銘柄はどの業種に恩恵をもたらしますか?
要点:恩恵を受ける企業は、NPU設計・DSP・IPを保有するファブレス企業、ファウンドリー・パッケージング、メモリー(HBM)サプライヤー、組み込みソフトウェア企業などに分かれます。